Durante buena parte de la jornada médica actual, el problema no es solamente tomar decisiones clínicas. También es encontrar la información necesaria para poder tomarlas.
Un paciente puede llegar a la consulta con estudios impresos, archivos PDF, imágenes almacenadas en distintos portales, resultados enviados por correo electrónico o WhatsApp, recetas emitidas desde otra plataforma y antecedentes distribuidos entre varias instituciones que no comparten sus sistemas. El médico debe reconstruir esa información, incorporarla a la historia clínica, decidir qué es relevante y, una vez tomada una conducta, volver a cargar parte de esos mismos datos en recetas electrónicas, formularios de autorización o plataformas de diferentes obras sociales.
En ese escenario está apareciendo la inteligencia artificial.
No necesariamente mediante grandes proyectos hospitalarios ni sofisticados sistemas institucionales. Muchas veces aparece porque un profesional descubre que un modelo de lenguaje puede ayudarlo a ordenar una evolución, resumir una historia extensa, revisar una publicación, estructurar información proveniente de varios estudios o preparar una solicitud administrativa.
La velocidad con la que estas herramientas están siendo incorporadas supera ampliamente la velocidad con la que las instituciones sanitarias han podido definir políticas, estándares de seguridad y mecanismos de integración. La discusión acerca de si la inteligencia artificial debería utilizarse en medicina empieza, por lo tanto, a resultar insuficiente. Ya se utiliza y probablemente lo hará cada vez más.
La pregunta relevante es cómo incorporarla sin confundir una herramienta extraordinariamente eficaz para procesar información con un sustituto del razonamiento clínico, de la responsabilidad profesional o de la relación entre médico y paciente.
Los modelos actuales pueden resumir cientos de páginas, encontrar relaciones entre datos dispersos, reorganizar información desordenada, redactar documentos y colaborar en tareas que ocupan una parte importante del tiempo profesional. Al mismo tiempo, pueden omitir información decisiva, interpretar mal un contexto, confundir la secuencia temporal de los acontecimientos o afirmar con sorprendente seguridad algo que sencillamente no es cierto.
La cuestión central, por lo tanto, no consiste en decidir si la inteligencia artificial es buena o mala para la medicina. Consiste en comprender qué tareas conviene delegarle, cuáles necesitan supervisión y cuáles todavía deberían permanecer claramente bajo control humano.
De responder preguntas a participar del trabajo médico
Una parte importante del entusiasmo inicial por los grandes modelos de lenguaje surgió de su desempeño en exámenes médicos y conjuntos estandarizados de preguntas. Algunos modelos comenzaron a obtener resultados comparables o superiores a los de profesionales en determinadas evaluaciones, lo que rápidamente alimentó la idea de que una máquina capaz de superar un examen podría estar próxima a ejercer medicina.
El problema es que la consulta clínica rara vez se parece a un examen de opción múltiple. El paciente puede recordar mal una fecha, desconocer el nombre de un medicamento, traer estudios incompletos o describir sus síntomas de manera ambigua. La información relevante puede encontrarse distribuida entre informes de diferentes instituciones y a lo largo de varios años. Dos datos aparentemente secundarios pueden modificar completamente una hipótesis y, con frecuencia, la tarea más importante del médico no consiste en responder una pregunta sino en advertir qué pregunta todavía no fue formulada.
La medicina real exige reconocer información faltante, jerarquizar datos, identificar contradicciones, incorporar la evolución temporal y reconsiderar hipótesis cuando aparece nueva evidencia. Por eso obtener un buen resultado en un benchmark médico no demuestra automáticamente un desempeño equivalente en situaciones clínicas reales.
Quizás resulte más preciso pensar en la inteligencia artificial contemporánea no como un “médico artificial”, sino como una nueva capa para procesar, recuperar, transformar e integrar información. Vista de esta manera, su utilidad resulta menos espectacular, pero probablemente mucho más real.
La primera revolución puede ser administrativa y cognitiva
Una proporción creciente del trabajo médico transcurre frente a una computadora. Registrar consultas, revisar antecedentes, transcribir resultados, completar formularios, confeccionar certificados, preparar derivaciones, responder solicitudes administrativas y mantener actualizada la historia clínica consume horas que inevitablemente se restan de otras actividades.
Es probablemente en este terreno donde la inteligencia artificial generativa puede producir algunos de sus beneficios más inmediatos.
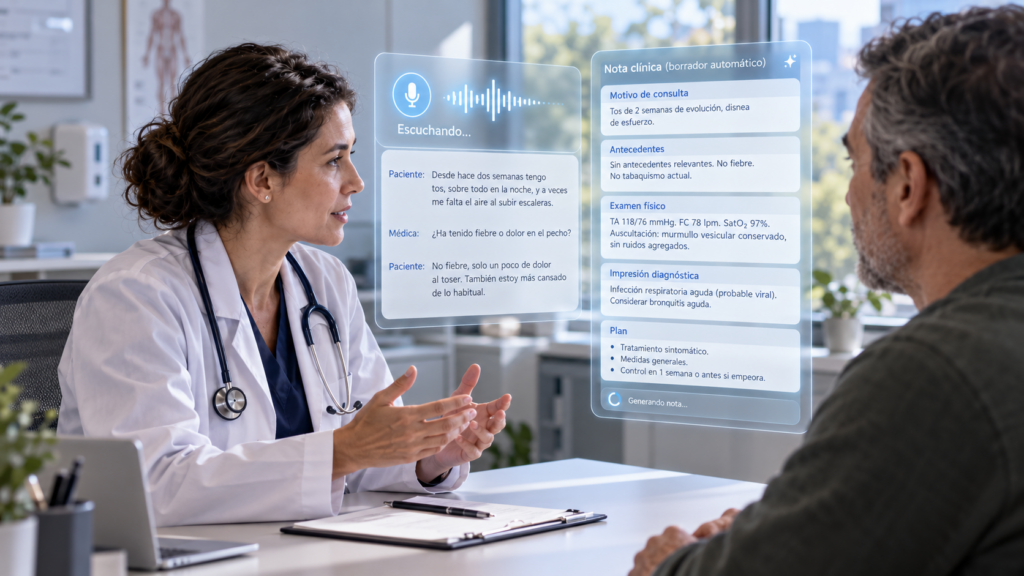
Un ejemplo son los denominados ambient scribes, expresión que podríamos traducir como asistentes de documentación clínica ambiental. Son sistemas que escuchan, con el consentimiento correspondiente, la conversación entre médico y paciente durante una consulta y luego utilizan reconocimiento de voz e inteligencia artificial para preparar un borrador de la evolución clínica.
La diferencia con un simple sistema de dictado es importante. El médico no necesita narrar formalmente “motivo de consulta”, “antecedentes” o “plan”. El sistema intenta extraer esos elementos de una conversación natural y organizarlos después dentro de una nota clínica estructurada.
Algunas instituciones de nuestro medio ya han comenzado a experimentar con esta modalidad, lo que convierte a los ambient scribes en una de las formas más concretas en las que la inteligencia artificial empieza a incorporarse a la práctica asistencial.
Su atractivo resulta evidente. Durante décadas la informatización prometió liberar tiempo médico, pero con frecuencia ocurrió lo contrario: una parte considerable de la consulta terminó dedicada a mirar una pantalla y documentar. Si un sistema puede registrar adecuadamente una conversación, preparar una evolución y permitir que el profesional la revise antes de firmarla, es posible recuperar parte de ese tiempo.
Los estudios iniciales de implementación muestran que estas herramientas pueden disminuir la carga documental, aunque también revelan errores, omisiones y formulaciones que necesitan corrección. Por eso el resultado debería considerarse un borrador clínico y no un registro automáticamente verdadero.
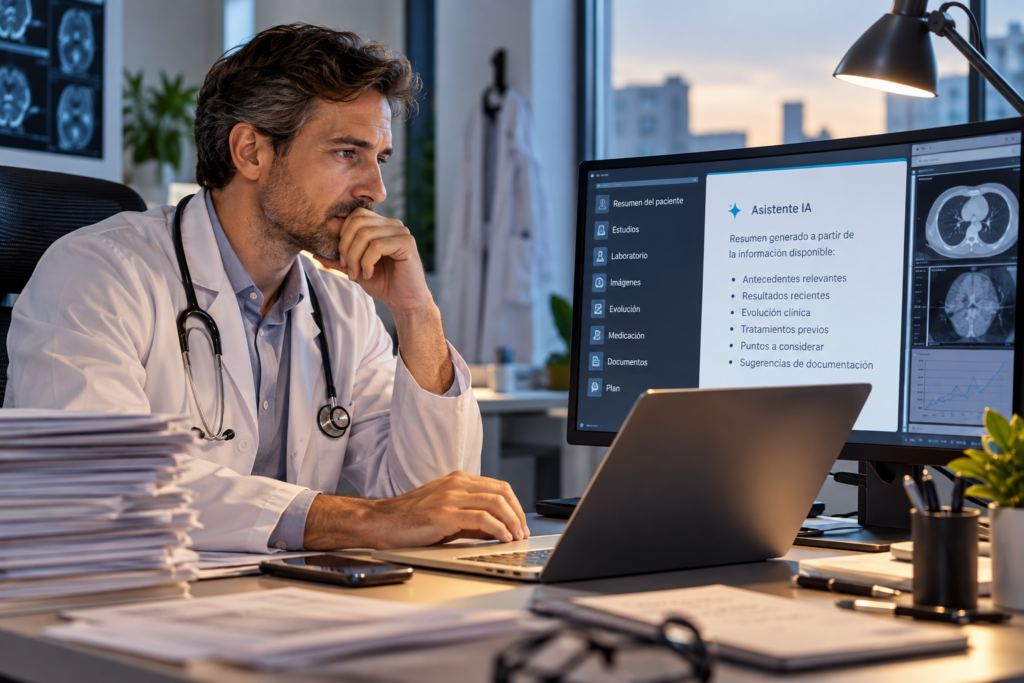
La documentación automática es solamente una parte del problema. Una historia clínica longitudinal puede contener decenas o cientos de consultas, resultados de laboratorio, estudios por imágenes, anatomías patológicas, cambios de medicación, internaciones y tratamientos. En esos casos el cuello de botella no es la ausencia de información sino nuestra capacidad limitada para reconstruir rápidamente su significado.
Un modelo puede resultar particularmente útil para producir una línea temporal, identificar tratamientos previos, encontrar la última determinación de un marcador, comparar estudios sucesivos o resumir una evolución oncológica de varios años. En este escenario la máquina no está decidiendo qué tratamiento indicar; está disminuyendo el costo cognitivo necesario para reunir la información sobre la cual el médico deberá decidir.
Esta diferencia puede resultar fundamental para comprender dónde se encuentra actualmente el mayor valor clínico de estas herramientas.
Cuando la IA deje de estar al lado de la historia clínica y pase a estar dentro de ella
Una parte importante del uso actual de inteligencia artificial ocurre todavía por fuera de los sistemas institucionales. El médico copia información, interactúa con otra aplicación, obtiene una respuesta y luego vuelve a la historia clínica.
Ese flujo es incómodo, aumenta la duplicación de tareas y plantea problemas de privacidad.
La transformación más importante probablemente ocurra cuando los modelos dejen de ser aplicaciones externas y se conviertan en una capa incorporada al propio sistema de historia clínica electrónica.
En la literatura informática es frecuente utilizar la sigla EMR, correspondiente a Electronic Medical Record. Para un lector clínico, podemos entenderla simplemente como historia clínica electrónica.
Una historia clínica electrónica integrada con inteligencia artificial podría presentar al comenzar una consulta un resumen actualizado de lo ocurrido desde la visita anterior, señalar resultados pendientes, comparar valores longitudinales, identificar cambios de medicación, preparar un borrador de evolución y recuperar antecedentes que hoy requieren navegar múltiples pantallas.
En lugar de preguntarle manualmente a un chatbot “¿qué pasó con este paciente?”, la propia historia clínica podría ofrecer una vista dinámica construida sobre sus datos, respetando permisos y dejando registro de qué información fue utilizada y qué respuesta produjo el sistema.
Esta integración permitiría además incorporar la IA dentro de la arquitectura de seguridad del propio sistema. La autenticación del profesional, los permisos, la trazabilidad, los registros de acceso y la delimitación de qué información puede utilizar el modelo podrían administrarse desde la misma infraestructura que protege actualmente la historia clínica.
Aquí aparece otro término que probablemente comenzaremos a encontrar con frecuencia: FHIR, sigla de Fast Healthcare Interoperability Resources.
FHIR es un estándar desarrollado para que distintos sistemas sanitarios puedan intercambiar información utilizando una estructura común. Explicado de manera sencilla, busca que un laboratorio, una historia clínica, un sistema de imágenes o una aplicación externa puedan “hablar un mismo idioma” al intercambiar datos sobre pacientes, resultados, medicamentos, diagnósticos o procedimientos.
FHIR no resuelve por sí mismo todos los problemas de interoperabilidad, pero ofrece una base muy importante para que un sistema de inteligencia artificial pueda consultar información sin depender exclusivamente de copiar y pegar documentos.
En un escenario ideal, la IA no debería leer pantallas como lo haría una persona para saber cuál fue la última creatinina del paciente. Podría solicitar al EMR ese dato mediante una interfaz estructurada y recibirlo con identificación de fecha, unidad y procedencia.
Ese tipo de integración reduce ambigüedad y mejora la trazabilidad.
La realidad argentina: la IA llega a un sistema todavía fragmentado
La discusión internacional sobre inteligencia artificial aplicada a la salud suele construirse a partir de sistemas sanitarios donde buena parte de la información clínica ya está digitalizada y donde existe un grado relativamente alto de interoperabilidad entre laboratorio, imágenes, historia clínica, farmacia y facturación.
Ese no es necesariamente el escenario en buena parte de Argentina.
En muchos ámbitos todavía conviven historias clínicas electrónicas con documentación en papel, estudios impresos, informes digitalizados sin estructura, archivos PDF, imágenes almacenadas en diferentes portales y sistemas administrativos que no se comunican entre sí. A esto se suma una modalidad extremadamente frecuente y difícil de ignorar: los pacientes o incluso otros profesionales envían estudios, fotografías de resultados e informes directamente por WhatsApp.
Para el médico, la realidad termina siendo una mezcla de información estructurada y no estructurada que debe reconstruirse manualmente. Un resultado puede encontrarse dentro del EMR, otro en un portal de laboratorio, otro en un PDF recibido por correo, una anatomía patológica puede llegar impresa y una fotografía del último laboratorio puede estar en un mensaje de WhatsApp.
La dificultad no se limita a recibir información dispersa. El profesional también debe producir datos repetidamente en distintos formatos. Puede registrar una consulta en una historia clínica, emitir una receta desde otra plataforma, completar una autorización en el portal de una obra social, adjuntar estudios en un tercer sistema y volver a cargar diagnóstico, estadio, peso, tratamiento, dosis y justificación cada vez que cambia de entorno.
Una misma decisión clínica termina siendo transcripta varias veces.
Esta fragmentación consume una cantidad considerable de tiempo profesional y agrega oportunidades de error. El médico dedica una parte creciente de su jornada no solamente a decidir qué necesita el paciente, sino a trasladar esa decisión entre sistemas que no se comunican.
En ese contexto, una de las contribuciones más importantes de la inteligencia artificial podría consistir precisamente en actuar como una capa de integración sobre un ecosistema imperfecto.
Un sistema podría extraer información de un laboratorio en PDF, reconocer valores presentes en una fotografía enviada por WhatsApp, interpretar un informe escaneado, incorporar resultados relevantes al EMR, comparar estudios previos o preparar los campos requeridos por una plataforma administrativa sin obligar al médico a volver a transcribirlos.
Cuando exista interoperabilidad mediante API o estándares como FHIR, la IA podría trabajar sobre datos estructurados y transferir información de manera más segura. Cuando esa interoperabilidad no exista, podría cumplir una función transitoria igualmente importante: leer documentos, identificar campos, estructurar información y ayudar a trasladarla entre formatos humanos y sistemas digitales.
La IA podría convertirse así, durante una etapa de transición, en un puente entre sistemas que todavía no saben comunicarse.
Pero esa misma capacidad introduce riesgos importantes.
Muchas plataformas utilizadas por obras sociales y financiadores no realizan solamente tareas administrativas. También forman parte del circuito mediante el cual se solicitan, autorizan o incluso prescriben tratamientos.
La automatización deja entonces de ser puramente burocrática.
Un sistema que complete automáticamente un número de afiliado no plantea el mismo riesgo que otro capaz de cargar una dosis de quimioterapia, seleccionar una presentación farmacológica o enviar una solicitud de autorización para un tratamiento oncológico.
En esos casos un error de lectura, una inferencia incorrecta o una simple equivocación de transcripción puede transformarse en una acción clínica.
La frontera entre automatización administrativa y automatización clínica es, por lo tanto, mucho menos clara de lo que parece. La inteligencia artificial puede ahorrar una enorme cantidad de tiempo preparando formularios, recuperando antecedentes, adjuntando documentación y trasladando datos entre sistemas, pero las acciones que impliquen dosis, tratamientos o decisiones con consecuencias para el paciente deberían conservar un punto explícito de validación humana antes de su envío definitivo.
La distinción entre copiloto y piloto automático adquiere aquí un sentido muy concreto. La IA puede preparar el trabajo, completar campos, reunir documentación y señalar inconsistencias; el profesional debe conservar el control de las decisiones que transforman esa información en una conducta clínica.
Una adopción que comenzó desde abajo
En países como Argentina existe otra particularidad: buena parte de la adopción inicial de inteligencia artificial está ocurriendo por iniciativa de los propios profesionales antes que por políticas institucionales.
Esto no resulta sorprendente. Los grandes sistemas sanitarios y los hospitales cambian lentamente. Incorporar una nueva tecnología exige evaluar seguridad, costos, contratos, infraestructura, responsabilidad legal, capacitación e integración con sistemas existentes. El profesional individual, en cambio, puede descubrir una herramienta y comenzar a utilizarla en cuestión de minutos.
Muchas veces la motivación es extremadamente concreta. No se trata de “transformar la medicina mediante inteligencia artificial”, sino de resolver un problema del martes por la tarde: ordenar veinte páginas de antecedentes, resumir una internación, estructurar una evolución, preparar una autorización o encontrar rápidamente información dentro de varios documentos. También puede significar algo todavía más cotidiano: responder con evidencia sólida a una auditoría que cuestiona una indicación, reconstruir rápidamente los fundamentos de una decisión terapéutica y hacerlo, si es posible, sin perder los estribos frente a una nueva solicitud de documentación. En ese tipo de situaciones la IA no reemplaza el conocimiento del médico, pero puede ayudar a reunir antecedentes, localizar bibliografía, ordenar argumentos y transformar una respuesta improvisada en una justificación clara, documentada y verificable.
Esta adopción desde abajo tiene una ventaja importante. La innovación aparece vinculada a necesidades reales.
Sin embargo, también genera una situación paradójica: una institución puede tener decenas de profesionales utilizando inteligencia artificial en su actividad cotidiana sin disponer todavía de una política institucional sobre inteligencia artificial.
Cada usuario puede emplear herramientas diferentes, bajo condiciones de privacidad distintas y con criterios heterogéneos acerca de qué información puede cargarse, cómo debe anonimizarse y qué resultados requieren verificación.
El desafío para los hospitales probablemente ya no consista únicamente en decidir si quieren incorporar inteligencia artificial. En muchos casos deberán alcanzar una práctica que comenzó antes que ellos.
Una respuesta exclusivamente prohibitiva puede resultar poco efectiva, porque puede desplazar el uso hacia espacios menos visibles. La alternativa tampoco puede ser aceptar cualquier utilización sin reglas.
Las instituciones deberían ofrecer herramientas aprobadas, establecer políticas sobre datos clínicos, definir diferentes niveles de riesgo, proporcionar mecanismos de anonimización, desarrollar capacitación y, progresivamente, integrar aquellas aplicaciones que demuestren utilidad dentro del propio ecosistema informático.
A medida que la inteligencia artificial se vuelva habitual, la ausencia de una estrategia institucional dejará de ser una posición neutral. Si los profesionales ya utilizan estas herramientas y la institución no ofrece criterios ni alternativas seguras, el riesgo no desaparece; simplemente queda distribuido y fuera de control.
Redactar no es decidir
Los modelos de lenguaje son particularmente buenos transformando información existente. Pueden convertir notas desordenadas en una evolución coherente, reformular un informe, preparar una carta de derivación o adaptar una explicación técnica para un paciente.
En estas tareas la inteligencia artificial trabaja fundamentalmente sobre la forma de la información.
El riesgo cambia cuando comenzamos a pedirle que modifique el contenido clínico. No es equivalente ordenar una historia ya conocida que decidir si una tomografía demuestra progresión, recomendar suspender un tratamiento o seleccionar una nueva línea terapéutica.
Esta diferencia puede convertirse en uno de los criterios más útiles para incorporar IA a la práctica diaria. Cuanto más cerca se encuentre la tarea de organizar, recuperar o transformar información, mayor autonomía puede concederse al sistema. Cuanto más cerca se encuentre de una decisión con consecuencias clínicas, mayor debe ser la supervisión humana.
Alucinaciones: el problema no es solamente que la IA pueda equivocarse
La palabra “alucinación” se utiliza para describir respuestas generadas por un modelo que parecen plausibles pero no se encuentran sustentadas por los datos disponibles o son directamente falsas. El término puede inducir a pensar que se trata de un comportamiento excepcional, cuando en realidad deriva de la propia naturaleza de los modelos generativos.
Un modelo de lenguaje produce una continuación probable a partir del contexto recibido. Su objetivo fundamental no es recuperar una verdad almacenada como si fuera una base de datos, sino generar una respuesta lingüísticamente coherente. Los modelos modernos han mejorado enormemente en razonamiento, uso de herramientas y verificación, pero esta distinción sigue siendo fundamental.
En medicina, una alucinación puede asumir formas mucho más sutiles que inventar un diagnóstico absurdo. Puede desplazar una fecha, atribuir un tratamiento al paciente equivocado, interpretar una abreviatura de manera incorrecta, afirmar que se realizó un estudio que en realidad estaba solicitado pero no efectuado, confundir una dosis, omitir una contraindicación o presentar como recomendación de una guía algo que esa guía nunca afirmó.
En un resumen de una historia clínica extensa, el problema puede ser incluso más complejo. El modelo puede realizar veinte afirmaciones correctas y una incorrecta. Esa única afirmación puede pasar inadvertida precisamente porque todo el resto del documento parece impecable.
También existe una segunda forma de alucinación que merece atención: la fabricación de referencias. Durante años los modelos fueron capaces de producir autores, títulos de artículos, revistas, años e incluso identificadores perfectamente verosímiles pero inexistentes. Los sistemas modernos reducen considerablemente este problema cuando pueden acceder a búsqueda y fuentes verificables, pero solicitar bibliografía a un modelo desconectado de fuentes reales continúa siendo una práctica que requiere cautela.
Un tercer problema aparece cuando el modelo intenta completar silenciosamente los vacíos del contexto. Si una historia señala que “se evaluará iniciar tratamiento” y meses después aparece un control, el sistema puede inferir incorrectamente que ese tratamiento efectivamente comenzó. Para una persona que conoce el caso, el error puede resultar evidente; para alguien que lee solamente el resumen generado, puede convertirse en un nuevo “hecho”.
Existe además un tipo de error particularmente relevante en medicina longitudinal: la pérdida de temporalidad. Un modelo puede reconocer correctamente dos hechos pero relacionarlos en el orden equivocado. Puede interpretar una progresión radiológica como posterior a un cambio terapéutico cuando ocurrió antes, o atribuir un efecto adverso a un tratamiento que todavía no había comenzado.
También puede conservar correctamente los datos individuales pero perder su jerarquía. Una historia puede contener decenas de resultados normales y una única alteración crítica. Un resumen estadísticamente plausible puede dedicar más espacio a la información frecuente que al dato verdaderamente decisivo.
Por eso una buena implementación no debería limitarse a pedir “resumir esta historia clínica”. Debería obligar al sistema a distinguir aquello que está explícitamente documentado de aquello que constituye una inferencia, mantener fechas y fuentes vinculadas a cada dato cuando sea posible y permitir regresar rápidamente al documento original.
La cuestión no es exigir que la inteligencia artificial jamás se equivoque. Ningún médico cumple ese estándar. La cuestión es diseñar el flujo de trabajo de modo que sus errores sean detectables antes de convertirse en decisiones clínicas.
El problema de confiar cuando funciona demasiado bien
Las herramientas mediocres generan desconfianza y obligan a revisar todo. Las herramientas muy buenas producen un fenómeno diferente: cuando han acertado cientos de veces, el usuario comienza a revisar menos.
Este sesgo de automatización puede convertirse paradójicamente en uno de los principales riesgos de los sistemas más avanzados. A medida que la tasa de error disminuye, cada error individual puede resultar más difícil de detectar porque hemos aprendido a confiar en el sistema.
El desafío de seguridad, por lo tanto, no consiste exclusivamente en mejorar la precisión de los modelos. También exige diseñar interfaces y rutinas que mantengan al profesional involucrado en los puntos donde su intervención sigue siendo necesaria.
Un sistema que genere un resumen y permita abrir con un clic el fragmento original del que obtuvo cada dato probablemente sea más seguro que otro que entregue simplemente una síntesis impecablemente redactada sin mostrar cómo llegó a ella.
¿Es mala praxis no utilizar inteligencia artificial en 2026?
La pregunta resulta deliberadamente provocadora, pero anticipa una discusión que probablemente ocupará a la medicina durante los próximos años.
Hoy no puede sostenerse que un médico que no utiliza inteligencia artificial esté incurriendo por ese solo hecho en mala praxis. Los estándares de validación, regulación y uso clínico todavía se encuentran en desarrollo.
Pero el problema se vuelve más interesante si imaginamos una situación futura en la que una herramienta determinada haya demostrado, mediante evidencia robusta, reducir errores diagnósticos, advertir interacciones peligrosas o detectar sistemáticamente una alteración que un profesional puede pasar por alto.
En ese contexto aparecerá una pregunta incómoda: si una tecnología accesible, validada y aceptada por la comunidad médica reduce de manera demostrable un riesgo, ¿en qué momento deja de ser opcional utilizarla?
La historia de la medicina ofrece precedentes. Hubo un momento en que no disponer de una tomografía no constituía una deficiencia asistencial porque sencillamente no era parte de la práctica habitual. Cuando una tecnología demuestra utilidad, se difunde y pasa a formar parte del estándar, ignorarla puede adquirir otro significado.
Probablemente con la IA ocurra algo parecido, pero no con “la inteligencia artificial” en general. El estándar de cuidado podría incorporar herramientas específicas para tareas específicas después de suficiente validación, de la misma forma en que incorporó escalas de riesgo, sistemas de interacción farmacológica o nuevos métodos diagnósticos.
Por ahora, probablemente resulte más prudente reconocer los riesgos de ambos extremos: utilizar ciegamente una herramienta no validada para tomar decisiones importantes o rechazar sistemáticamente una tecnología útil sin siquiera evaluar qué puede aportar.
No todos los modelos hacen lo mismo: Sol, Astra y la velocidad del cambio
Otro problema para los médicos que intentan comprender estas herramientas es que hablar de “ChatGPT” o de “un modelo de inteligencia artificial” como si se tratara de una tecnología estática resulta cada vez menos preciso.
GPT-5.6 Sol está orientado al trabajo profesional complejo, investigación, ciencia y tareas que requieren razonamiento prolongado. En la práctica resulta particularmente útil cuando se necesita analizar documentos extensos, integrar varias fuentes, comparar alternativas o sostener un análisis relativamente profundo.
Astra representa una generación posterior más orientada a resolver tareas complejas de principio a fin, combinando razonamiento con navegación, utilización de herramientas y capacidad de actuar sobre distintos entornos.
Desde el punto de vista clínico, esta diferencia es relevante porque un modelo puede limitarse a producir una respuesta mientras otro puede participar además de un flujo operativo.
Esto introduce una nueva dimensión de riesgo. Una inteligencia artificial que solamente responde una pregunta puede equivocarse en una respuesta. Una IA capaz de interactuar con sistemas, completar formularios o ejecutar acciones puede transformar ese error en una acción concreta.
Por eso una mayor capacidad no elimina la necesidad de supervisión. En algunos contextos puede incluso aumentarla.
En salud probablemente convenga abandonar la pregunta “¿cuál es el mejor modelo?” y reemplazarla por otra más específica: “¿qué modelo, con qué herramientas y bajo qué controles es apropiado para esta tarea?”.
Privacidad: copiar una historia clínica en un chatbot no es un acto neutro
Cuando se utilizan modelos generales con información médica aparece un problema que no existe cuando se pide ayuda para analizar un texto público.
Una historia clínica contiene información especialmente sensible. Por eso el hecho de quitar el nombre antes de copiar un caso no garantiza necesariamente que el paciente haya quedado anonimizado.
Un texto que diga “varón de 47 años, intendente de una localidad pequeña, accidentado el 3 de febrero y trasladado en helicóptero” puede resultar identificable sin mencionar nombre, DNI ni teléfono. La combinación de características poco frecuentes puede ser suficiente.
Anonimizar implica reducir razonablemente la posibilidad de reidentificación, no simplemente eliminar los campos obvios.
Antes de utilizar información clínica fuera de un entorno institucional controlado deberían eliminarse nombres y apellidos, DNI, números de afiliación, teléfonos, correos electrónicos, domicilios, números de historia clínica y otros identificadores directos. También conviene sustituir las fechas exactas por referencias relativas cuando el día concreto no sea clínicamente importante y evitar localidades pequeñas, empleadores, profesiones infrecuentes o circunstancias personales que permitan reconocer al paciente.
Cuando la edad exacta sea clínicamente necesaria debería conservarse. Cuando no lo sea puede utilizarse un rango. Anonimizar no significa destruir la información útil, sino conservar su valor clínico reduciendo los elementos que permiten identificar a una persona.
También conviene distinguir anonimización de seudonimización. En la primera, la información debería quedar razonablemente desligada de una identidad recuperable. En la segunda, los identificadores se sustituyen por códigos, pero continúa existiendo un mecanismo que permite reconstruir la identidad.
En una institución, parte de este proceso podría automatizarse. Antes de enviar información a un modelo externo, otro sistema podría detectar nombres, documentos, teléfonos, direcciones y otros identificadores y reemplazarlos por etiquetas neutras.
Sin embargo, tampoco debería suponerse que la anonimización automatizada es infalible. El texto libre puede contener identificadores poco evidentes y las combinaciones de datos pueden permitir una reidentificación incluso después de haber eliminado los campos más obvios.
IA local: cuando los datos no necesitan salir de la institución
Una alternativa especialmente interesante consiste en ejecutar modelos de lenguaje dentro de infraestructura propia.
Herramientas como Ollama permiten descargar y ejecutar modelos localmente en una computadora o servidor. Un modelo de la familia Llama, por ejemplo, puede funcionar dentro de la propia red institucional sin que cada consulta deba enviarse necesariamente a un proveedor externo.
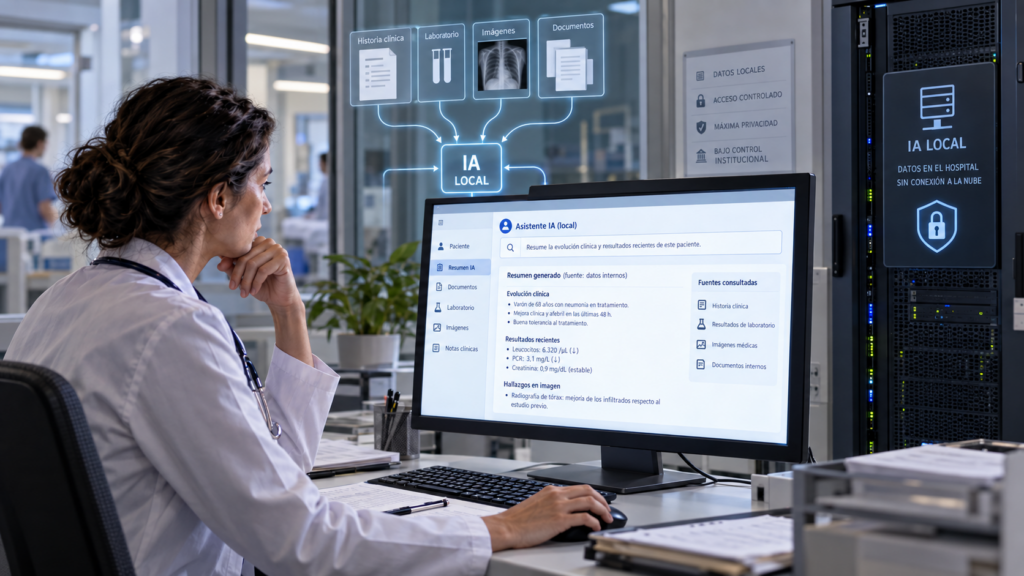
Es importante distinguir ambos conceptos. Ollama no es el modelo de inteligencia artificial; es una plataforma que facilita ejecutar modelos en forma local. Llama, Gemma u otros modelos constituyen el motor de lenguaje propiamente dicho.
Sobre esa base puede construirse una interfaz clínica, conectarla a un repositorio documental o incorporar un sistema de recuperación aumentada por generación, conocido como RAG.
En un sistema RAG, el modelo no necesita “saber” toda la historia clínica. Frente a una pregunta, el sistema busca primero dentro de los documentos autorizados los fragmentos relevantes y los entrega al modelo como contexto.
Si preguntamos cuál fue el último tratamiento recibido por un paciente o cómo evolucionó su creatinina durante el último año, el sistema puede recuperar primero los documentos correspondientes y luego elaborar una respuesta basada en ellos.
Esta arquitectura ofrece dos ventajas importantes. Por un lado mantiene los documentos bajo control institucional. Por otro, reduce la dependencia del conocimiento interno del modelo, porque permite obligarlo a responder a partir de fuentes concretas.
Sin embargo, “local” no significa automáticamente “seguro”. Un servidor sin actualizaciones, con contraseñas débiles, carpetas compartidas indiscriminadamente o ausencia de registros de acceso puede representar un riesgo mayor que un buen servicio en la nube correctamente administrado.
La IA local exige las mismas preguntas que cualquier sistema clínico serio: quién puede acceder, qué queda registrado, cómo se realizan los respaldos, qué ocurre ante una falla, quién actualiza los modelos y cómo se verifica que una nueva versión no haya modificado su comportamiento.
Probablemente el mayor valor inicial de estos sistemas locales no esté en decidir tratamientos sino en resumir historias, clasificar documentos, recuperar antecedentes, extraer resultados y facilitar búsquedas internas.
En otras palabras, utilizar inteligencia artificial primero para hacer más accesible la información clínica antes de utilizarla para interpretar esa información.
Del experimento a la producción clínica
Una distinción que debería hacerse explícita desde el comienzo es la separación entre experimentar con inteligencia artificial y utilizarla en producción asistencial.
Instalar Ollama en una computadora, cargar un modelo y comprobar que puede resumir una historia clínica constituye un experimento. Puede ser extremadamente valioso, pero todavía no es un sistema clínico.
Un entorno de producción exige autenticación, perfiles de acceso, cifrado, respaldo, registro de consultas, control de versiones, mecanismos para detectar errores y políticas claras acerca de qué información puede procesarse.
También debería permitir identificar qué modelo produjo cada salida y, cuando sea posible, conservar las fuentes utilizadas.
La medicina ya aprendió esta diferencia con otras tecnologías. Un archivo Excel puede resultar excelente para explorar una hipótesis, pero nadie debería convertir automáticamente ese archivo en la base de datos crítica de un hospital.
Con la inteligencia artificial debería ocurrir lo mismo.
El médico seguirá siendo responsable, pero su trabajo probablemente cambie
Una recomendación producida por inteligencia artificial no adquiere valor clínico simplemente porque haya sido generada por un modelo sofisticado. El profesional sigue necesitando comprenderla, verificarla y decidir si corresponde aplicarla.
Sin embargo, afirmar solamente que “el médico debe revisar todo” tampoco constituye una estrategia sostenible.
Si la IA termina participando en cada consulta, será necesario diseñar sistemas donde la revisión se concentre en aquello que realmente importa.
No tiene sentido revisar palabra por palabra una carta administrativa generada automáticamente con el mismo nivel de intensidad con que debería revisarse una recomendación terapéutica.
La supervisión también debe ser proporcional al riesgo.
A medida que estos sistemas mejoren, la competencia profesional probablemente incluya una nueva habilidad: saber qué delegar a una IA, qué verificar y qué no debería delegarse.
¿La inteligencia artificial reemplazará al médico?
Probablemente sea una de las preguntas menos útiles del debate.
Las tecnologías suelen reemplazar tareas antes que profesiones completas. La calculadora no eliminó al contador y la tomografía no eliminó al radiólogo, pero ambas transformaron profundamente la manera de trabajar.
Con la inteligencia artificial probablemente ocurra algo similar. La documentación puede automatizarse parcialmente, la búsqueda de información será mucho más rápida, el acceso a la bibliografía será más eficiente y una parte importante del trabajo de organización podrá delegarse.
Esto puede liberar tiempo, pero no garantiza que ese tiempo se utilice mejor. Si veinte minutos ahorrados en documentación se convierten simplemente en cuatro consultas adicionales, habremos aumentado productividad sin necesariamente mejorar la medicina.
Si ese tiempo permite escuchar mejor al paciente, revisar un caso complejo o discutir una decisión, la historia puede ser diferente.
Quizás el efecto más interesante de la inteligencia artificial no sea permitir que una computadora ejerza medicina, sino liberar al médico de algunas tareas para que pueda volver a dedicar más tiempo a ejercerla.
Una tecnología más poderosa exige una medicina más crítica
La inteligencia artificial generativa constituye probablemente uno de los cambios tecnológicos más importantes que haya enfrentado la medicina digital.
Ignorarla no parece razonable. Adoptarla sin criterio tampoco.
La estrategia más sensata se encuentra entre ambos extremos: utilizarla allí donde reduce trabajo mecánico y mejora el acceso a información, exigir fuentes cuando la precisión importa, proteger los datos de los pacientes, integrar los sistemas dentro de arquitecturas auditables y conservar la supervisión profesional en las decisiones que pueden producir daño.
La evolución reciente de los modelos muestra además que estamos frente a una tecnología que cambia en meses, no en décadas. Lo que hoy requiere supervisión intensiva puede convertirse mañana en una herramienta rutinaria y aquello que hoy parece excepcional puede terminar formando parte del estándar de atención.
Por eso quizás la pregunta más útil frente a cada nueva aplicación no sea si la inteligencia artificial puede hacer una determinada tarea.
La pregunta debería ser otra:
¿En qué parte de este proceso puede ayudarnos, qué riesgo introduce y cómo conservamos el control clínico cuando la utilizamos?
Responder correctamente esas tres preguntas probablemente será una de las nuevas competencias de la medicina de los próximos años.