Durante buena parte de la historia de la farmacología, descubrir un medicamento ha significado buscar una aguja en un pajar extraordinariamente grande. Los investigadores identifican un mecanismo relacionado con una enfermedad, seleccionan una posible proteína sobre la cual intervenir, prueban miles o millones de compuestos, modifican los candidatos más prometedores y, después de años de experimentación, algunos pocos llegan finalmente a probarse en seres humanos.
La inteligencia artificial está empezando a modificar esa lógica. El cambio no consiste simplemente en analizar más rápido grandes cantidades de información: los nuevos modelos pueden predecir estructuras moleculares, estimar cómo interactúan diferentes moléculas y, cada vez más, proponer estructuras nuevas que podrían presentar determinadas propiedades.
AlphaFold 3 es uno de los ejemplos más importantes de esta transformación, pero para comprender por qué resulta tan relevante conviene recordar de dónde venimos. Durante décadas, conocer la forma de una proteína podía significar años de trabajo, experimentos fallidos y prueba y error. Hoy, una inteligencia artificial puede producir en un tiempo incomparablemente menor una predicción estructural que, aunque no reemplaza al laboratorio, puede cambiar completamente el punto desde el cual comienza una investigación. Y ese podría ser apenas el primer paso.
El problema de conocer la forma de una proteína
Las proteínas realizan buena parte del trabajo dentro de nuestras células. Actúan como enzimas, receptores, señales, transportadores y componentes estructurales. Pero conocer la secuencia de aminoácidos que forma una proteína no significa necesariamente conocer su estructura. Una proteína es una larga cadena de aminoácidos que se pliega sobre sí misma hasta adoptar una compleja forma tridimensional, y esa forma resulta fundamental para determinar cómo funciona, con qué otras moléculas puede interactuar y, en muchos casos, cómo podría ser bloqueada o modificada mediante un medicamento.
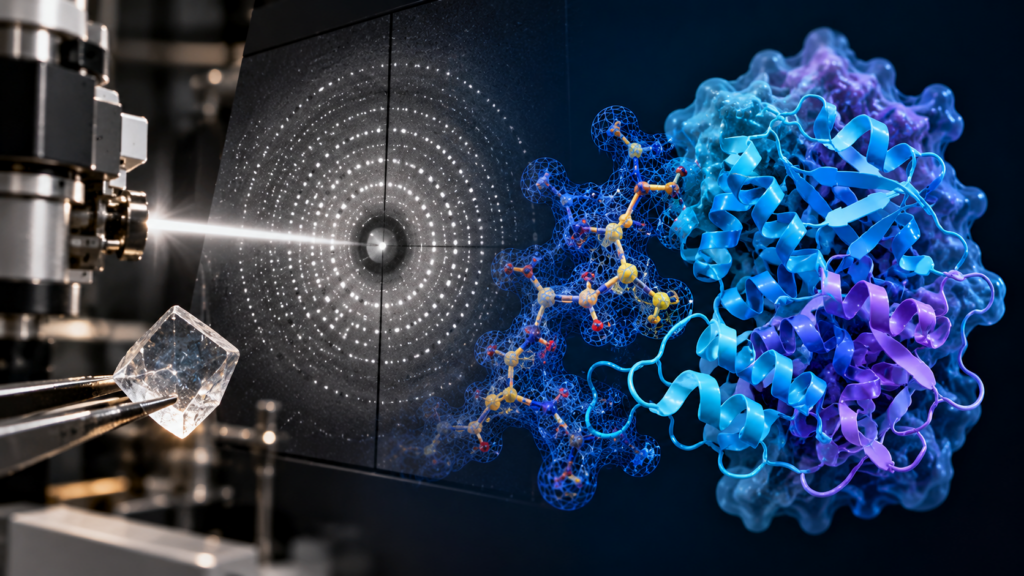
Durante décadas, obtener esa estructura fue un formidable problema experimental. Uno de los principales métodos utilizados fue la cristalografía de rayos X. Simplificando mucho el proceso, primero era necesario producir y purificar la proteína y conseguir que formara un cristal suficientemente ordenado, algo que podía convertirse por sí mismo en una tarea difícil y prolongada.
No se trataba simplemente de tomar una fotografía con rayos X. Había que encontrar las condiciones adecuadas para mantener estable la proteína y conseguir su cristalización. Cambiar la temperatura, el pH, las concentraciones o las soluciones utilizadas podía significar comenzar una nueva serie de experimentos. Muchas veces los cristales simplemente no aparecían; otras veces aparecían, pero no tenían la calidad necesaria para obtener una estructura útil.
Conseguir el cristal era solamente una parte del problema. Después debía exponerse a rayos X y analizarse el patrón de difracción producido. A partir de esa información era posible reconstruir la distribución de electrones y finalmente deducir la posición tridimensional de los átomos que componían la proteína. Algunas estructuras importantes requirieron años de trabajo de equipos completos de investigadores, mientras que otras sencillamente permanecieron fuera de nuestro alcance.
Con el tiempo se incorporaron otras herramientas. La resonancia magnética nuclear permitió estudiar determinadas proteínas y sus movimientos en solución, mientras que la criomicroscopía electrónica experimentó un extraordinario desarrollo y permitió determinar grandes estructuras moleculares sin necesidad de cristalizarlas. Todas estas técnicas continúan siendo fundamentales, pero requieren equipamiento especializado, muestras biológicas, experiencia y una considerable cantidad de trabajo experimental.
Mientras tanto, existía una pregunta que intrigaba a los científicos desde hacía décadas: si conocemos la secuencia de aminoácidos de una proteína, ¿podríamos calcular directamente qué forma tridimensional adoptará?
El problema resultó extraordinariamente difícil. Una cadena de aminoácidos puede adoptar un número inmenso de configuraciones posibles y determinar cuál será su estructura estable a partir de la secuencia se convirtió en uno de los grandes desafíos de la biología computacional. Ahí es donde AlphaFold cambió la historia.
En 2020, AlphaFold 2, desarrollado por Google DeepMind, demostró que la inteligencia artificial podía predecir la estructura tridimensional de numerosas proteínas a partir de su secuencia de aminoácidos con una precisión que hasta entonces parecía difícil de alcanzar mediante métodos computacionales. Lo extraordinario no era simplemente obtener una atractiva representación tridimensional en una computadora, sino poder producir en minutos u horas —dependiendo de la complejidad de la proteína y de los recursos computacionales disponibles— una predicción estructural útil para problemas que tradicionalmente podían requerir meses o años de trabajo experimental.
AlphaFold no hizo innecesarias la cristalografía de rayos X, la resonancia magnética nuclear ni la criomicroscopía electrónica. Las estructuras experimentales continúan siendo fundamentales y, de hecho, fueron indispensables para entrenar y validar estos modelos. Lo que cambió radicalmente fue el punto de partida. Ya no siempre teníamos que comenzar completamente a ciegas.
Cuatro años después llegó AlphaFold 3, y el problema que intentaba resolver era considerablemente más ambicioso.
AlphaFold 3: ya no se trata solamente de proteínas
AlphaFold 3 amplió el objetivo de sus predecesores. Ya no intenta solamente predecir cómo se pliega una proteína, sino modelar complejos formados por diferentes moléculas biológicas. El sistema puede trabajar con proteínas, ADN, ARN, pequeñas moléculas, iones y determinadas modificaciones químicas e intentar predecir cómo interactúan entre sí.
Para el desarrollo de medicamentos, esa capacidad resulta especialmente interesante. Podemos imaginarlo mediante una analogía sencilla: conocer la estructura de una proteína equivale aproximadamente a conocer la forma de una cerradura, mientras que comprender cómo diferentes moléculas interactúan con ella comienza a mostrarnos qué tipo de llave podría encajar. Pero todavía queda un problema considerablemente más difícil: diseñar esa llave.
De predecir moléculas a diseñarlas
Aquí aparece otra rama de la inteligencia artificial: los modelos generativos. Un sistema generativo no necesita limitarse a analizar moléculas existentes, sino que puede proponer estructuras nuevas intentando satisfacer determinadas condiciones.
En teoría, el proceso puede comenzar con una proteína relacionada con una enfermedad. Los modelos analizan su estructura y sus posibles sitios de unión; otros algoritmos generan moléculas candidatas y estiman propiedades como afinidad, estabilidad o determinadas características farmacológicas, y las alternativas consideradas más prometedoras pasan posteriormente a síntesis y experimentación.
El cambio conceptual es considerable. El descubrimiento tradicional de medicamentos ha dependido en buena medida de explorar enormes bibliotecas de compuestos buscando aquellos que presentan alguna actividad interesante. La inteligencia artificial plantea la posibilidad de recorrer ese gigantesco espacio químico de una manera mucho más dirigida. En lugar de buscar solamente una llave entre millones de llaves existentes, empezamos a preguntarnos si podemos diseñarla.
Esto no significa que el laboratorio vaya a desaparecer. Las moléculas propuestas por una computadora deben ser sintetizadas y posteriormente sometidas a pruebas bioquímicas, celulares, toxicológicas y finalmente clínicas. La diferencia potencial consiste en llegar al laboratorio con candidatos mejor seleccionados: la inteligencia artificial no elimina el experimento, pero puede ayudarnos a decidir qué experimentos merece la pena realizar.
Del algoritmo a la fase III
La pregunta decisiva es si todo esto funciona fuera de una computadora. Uno de los ejemplos más interesantes es rentosertib, anteriormente denominado ISM001-055, una pequeña molécula desarrollada para el tratamiento de la fibrosis pulmonar idiopática.
En este proyecto, plataformas de inteligencia artificial participaron tanto en la identificación de TNIK como posible blanco terapéutico como en el desarrollo posterior de una molécula destinada a inhibirlo. El programa consiguió algo mucho más importante que funcionar en una simulación: llegó a pacientes.
En 2025, Nature Medicine publicó los resultados de un ensayo fase IIa multicéntrico, doble ciego y aleatorizado en 71 pacientes con fibrosis pulmonar idiopática. Los participantes recibieron placebo o diferentes dosis de rentosertib durante 12 semanas. En el grupo tratado con 60 mg diarios se observó un aumento promedio de 98,4 ml en la capacidad vital forzada, frente a una disminución de 20,3 ml en el grupo placebo.
Los resultados fueron interesantes, aunque debían interpretarse con cautela. Se trataba de un estudio pequeño y de corta duración, que no permitía establecer todavía una eficacia clínica definitiva. En julio de 2026, sin embargo, Insilico Medicine anunció el inicio del desarrollo en fase III de rentosertib.
Esto convierte al programa en un caso particularmente relevante: un blanco terapéutico identificado mediante inteligencia artificial y una molécula desarrollada con participación importante de sistemas generativos han conseguido avanzar hasta una etapa clínica a la que habitualmente sólo llega una pequeña fracción de los candidatos iniciales.
Rentosertib todavía no es un medicamento aprobado y será necesario esperar los resultados de los estudios confirmatorios. Tampoco un único caso permite demostrar que la inteligencia artificial pueda producir sistemáticamente medicamentos mejores. Sí demuestra, en cambio, algo que hace pocos años parecía mucho más lejano: una molécula surgida de un proceso fuertemente asistido por inteligencia artificial puede recorrer el camino desde un algoritmo hasta ensayos clínicos avanzados.
La inteligencia artificial tampoco escapa al fracaso
Contar únicamente historias como la anterior resultaría atractivo, pero también engañoso. Algunos candidatos identificados o desarrollados mediante plataformas de inteligencia artificial llegaron a ensayos clínicos sin conseguir demostrar la eficacia esperada. La utilización de algoritmos no elimina uno de los principales obstáculos del desarrollo farmacológico: la extraordinaria complejidad de la biología humana.
Una molécula puede unirse perfectamente a una proteína en una simulación y fracasar como medicamento porque se absorbe mal, se metaboliza demasiado rápido, no alcanza el tejido adecuado, interactúa con otras proteínas, produce toxicidad o simplemente porque el mecanismo biológico que parecía fundamental no era tan importante como suponíamos.
El desarrollo de BEN-2293 por BenevolentAI constituye un ejemplo. La molécula, investigada para dermatitis atópica, llegó a un ensayo fase IIa y mostró un perfil de seguridad aceptable, pero no consiguió demostrar los resultados de eficacia esperados y el programa no continuó avanzando.
La diferencia entre diseñar una molécula interesante y desarrollar un medicamento continúa siendo enorme. Una perspectiva publicada en Nature Reviews Drug Discovery en 2026 señalaba precisamente esta dificultad: pese a la enorme cantidad de algoritmos, publicaciones e inversiones, la evidencia de que la inteligencia artificial ya esté produciendo medicamentos más seguros o eficaces para los pacientes continúa siendo limitada. La mayoría de los programas de compañías dedicadas prioritariamente al descubrimiento mediante IA permanecen en etapas preclínicas o clínicas iniciales.
Por eso sigue abierta una pregunta fundamental: ¿la inteligencia artificial permitirá solamente descubrir medicamentos más rápido o conseguirá también descubrir mejores medicamentos? Todavía no conocemos la respuesta.
AlphaFold 3 tampoco es una bola de cristal molecular
Las representaciones tridimensionales producidas por estos sistemas pueden transmitir una impresión engañosa de certeza. Una estructura molecular bellamente representada en una pantalla continúa siendo una predicción, y los propios desarrolladores de AlphaFold 3 describieron limitaciones relacionadas con determinadas conformaciones, estereoquímica, regiones desordenadas y predicciones incorrectas que pueden parecer estructuralmente plausibles.
Existe además una limitación conceptual importante: los sistemas biológicos son dinámicos. Las proteínas no son esculturas rígidas, sino estructuras que se mueven, cambian de conformación, interactúan con otras moléculas y funcionan dentro de ambientes celulares extremadamente complejos.
Un estudio posterior que comparó predicciones de AlphaFold 3 con estructuras experimentales de receptores acoplados a proteínas G mostró bien este problema. El sistema podía reproducir adecuadamente la arquitectura general de muchos receptores, pero la posición exacta de las pequeñas moléculas podía resultar incorrecta, particularmente en determinados sitios de unión alostéricos. Y unos pocos átomos ubicados en una posición diferente pueden importar enormemente cuando intentamos desarrollar un medicamento.
Por eso las estructuras experimentales y la validación en laboratorio continúan siendo fundamentales. AlphaFold 3 no reemplaza a la biología experimental: la complementa.
De la ciencia abierta al acceso controlado
La evolución de AlphaFold abrió también una discusión que va mucho más allá de la predicción de proteínas: ¿hasta qué punto deberían ser abiertos modelos de inteligencia artificial capaces de intervenir cada vez más profundamente sobre la biología?
AlphaFold 2 adoptó un modelo ampliamente abierto para la investigación. Su código fue publicado y sus parámetros quedaron disponibles para la comunidad científica, contribuyendo a una rápida expansión de su utilización en laboratorios de todo el mundo.
Cuando AlphaFold 3 fue presentado en 2024, Google DeepMind eligió inicialmente una estrategia considerablemente más restrictiva. El artículo científico describía el modelo, pero el código completo y sus parámetros no fueron liberados junto con la publicación. Para muchos investigadores, el acceso práctico se realizaba a través de AlphaFold Server, con determinadas limitaciones. La decisión produjo críticas relacionadas con la reproducibilidad científica y puso en evidencia una tensión que probablemente veremos repetirse durante los próximos años entre ciencia abierta, intereses comerciales y control de tecnologías cada vez más poderosas.
La situación posteriormente cambió. El código de AlphaFold 3 fue publicado y, desde junio de 2026, se distribuye bajo licencia Apache 2.0. Los parámetros entrenados del modelo —los llamados pesos—, sin embargo, permanecen bajo términos de uso separados que restringen su redistribución y determinados usos comerciales.
La distinción entre código y parámetros puede parecer técnica, pero es importante: tener el programa que define cómo funciona un modelo no equivale necesariamente a disponer libremente del modelo entrenado que permite reproducir todas sus capacidades.
Las restricciones tampoco pueden atribuirse exclusivamente a la bioseguridad. Intervienen cuestiones comerciales, propiedad intelectual y control sobre determinados usos, aunque los términos asociados al modelo contemplan también restricciones frente a aplicaciones peligrosas, ilegales o maliciosas.
El debate probablemente se repetirá con modelos futuros. La apertura favorece la reproducibilidad, permite que otros investigadores comprueben resultados y acelera la innovación; pero, a medida que estos sistemas dejan de limitarse a describir la biología y adquieren mayor capacidad para ayudar a diseñarla, aparece una pregunta nueva: ¿deberían todas esas capacidades estar disponibles sin ningún tipo de control?
Más allá de AlphaFold 3
La tecnología tampoco se detuvo en AlphaFold 3. En 2026, Isomorphic Labs —empresa de Alphabet surgida específicamente para aplicar inteligencia artificial al descubrimiento de medicamentos— presentó su Drug Design Engine (IsoDDE), que puede entenderse como una evolución de la línea tecnológica de AlphaFold hacia una plataforma específicamente orientada al diseño de fármacos. No se trata oficialmente de un «AlphaFold 4», sino de un sistema que intenta avanzar desde la predicción de estructuras e interacciones biomoleculares hacia problemas directamente relacionados con el desarrollo de nuevas moléculas.
La plataforma pretende ir más allá de la predicción estructural y abordar problemas directamente relacionados con el diseño farmacológico: predecir interacciones entre proteínas y ligandos, estimar afinidades y detectar posibles sitios de unión que podrían utilizarse para desarrollar nuevas moléculas.
La compañía ha comunicado resultados superiores a AlphaFold 3 en determinados benchmarks de interacción proteína-ligando. Es importante interpretar estas afirmaciones correctamente: se trata de resultados comunicados por la propia empresa y no equivalen todavía a demostrar que la plataforma produzca mejores medicamentos en pacientes. Pero muestran claramente la dirección que está tomando el campo.
AlphaFold ayudó inicialmente a responder cómo es una determinada estructura biológica. La siguiente generación de sistemas pretende abordar una pregunta bastante más ambiciosa: qué molécula deberíamos construir para modificarla.
Cuando la inteligencia artificial entra al laboratorio
Existe un paso adicional que puede resultar todavía más importante. Durante 2026, algunos de los principales desarrolladores de inteligencia artificial comenzaron a mostrar sistemas capaces de participar de una manera mucho más activa en el propio proceso de investigación biológica.
OpenAI, trabajando junto con Ginkgo Bioworks, conectó GPT-5 con un laboratorio automatizado para optimizar la producción de proteínas en sistemas libres de células. El modelo podía proponer condiciones experimentales, recibir los resultados obtenidos en el laboratorio y utilizar esa información para decidir nuevas iteraciones. Según los resultados publicados por los investigadores, el proceso consiguió reducir aproximadamente un 40 % el costo de producción de proteínas.
El dato económico es interesante, pero el concepto probablemente sea mucho más importante. La inteligencia artificial ya no se limita necesariamente a analizar información producida previamente por científicos, sino que puede comenzar a participar en un ciclo en el que formula o desarrolla una hipótesis, propone condiciones experimentales, recibe los resultados obtenidos y utiliza esa nueva información para decidir qué experimentar después.
En abril de 2026, OpenAI presentó además GPT-Rosalind, un modelo especializado en ciencias de la vida y orientado a biología, química, ingeniería de proteínas, genómica, descubrimiento de medicamentos y medicina traslacional. Desde septiembre, su acceso se amplió globalmente a organizaciones elegibles mediante un programa de acceso controlado.
Anthropic está explorando un camino similar. En experimentos publicados durante 2026, Claude coordinó diferentes herramientas computacionales especializadas para diseñar pequeñas proteínas capaces de unirse a blancos determinados. Los diseños fueron posteriormente sintetizados y evaluados experimentalmente por laboratorios externos. Se obtuvieron proteínas capaces de unirse a 14 de los 15 blancos estudiados y, dependiendo de la configuración utilizada, entre aproximadamente el 22 % y el 35 % de los diseños evaluados mostraron actividad de unión.
Son resultados prometedores, aunque deben interpretarse con la misma cautela que aplicamos a otros anuncios de este campo: proceden en buena medida de investigaciones realizadas o financiadas por las propias compañías y requieren validación independiente. Sin embargo, muestran una dirección tecnológica particularmente interesante.
Podríamos estar pasando progresivamente de una inteligencia artificial que responde preguntas científicas a otra capaz de actuar como un agente de investigación, consultando literatura, utilizando herramientas especializadas, generando hipótesis, diseñando moléculas, proponiendo experimentos y analizando sus resultados para decidir los pasos siguientes. Lejos de desaparecer, el laboratorio comienza así a conectarse directamente con la inteligencia artificial, cerrando progresivamente el circuito entre la predicción computacional y la experimentación biológica.
Ese cambio puede resultar mucho más transformador que disponer simplemente de un chatbot que conoce biología.
¿Medicamentos en meses en lugar de años?
Esta es probablemente una de las promesas más atractivas de la inteligencia artificial aplicada a la industria farmacéutica. El desarrollo tradicional de un medicamento puede prolongarse durante más de una década y consumir enormes recursos, mientras que las compañías dedicadas al descubrimiento mediante IA sostienen que determinadas etapas iniciales podrían comprimirse de años a meses.
Existen ejemplos que parecen respaldar parcialmente esa posibilidad. En el caso de rentosertib, sus desarrolladores informaron que la selección del candidato preclínico requirió aproximadamente 18 meses. Pero estas cifras deben interpretarse cuidadosamente, porque acelerar la identificación de un blanco o la generación de una molécula candidata no significa reducir en la misma proporción todo el desarrollo farmacológico.
Los estudios toxicológicos, las diferentes fases clínicas, la fabricación, el seguimiento de seguridad y la evaluación regulatoria continúan siendo necesarios. La verdadera revolución podría ser menos espectacular que algunos titulares y, al mismo tiempo, mucho más importante: si la inteligencia artificial consigue descartar tempranamente miles de alternativas poco prometedoras, el ahorro acumulado de tiempo, experimentos y recursos podría modificar sustancialmente la productividad de la investigación farmacéutica.
Todavía debemos demostrar que esto ocurra de manera consistente.
De buscar medicamentos a diseñarlos
Durante décadas hemos construido enormes bibliotecas de compuestos para probar cuáles podían tener alguna utilidad. Ahora aparece otra posibilidad: comenzar por preguntarnos qué propiedad necesitamos e intentar que un sistema computacional proponga una molécula capaz de proporcionarla.
Este cambio se extiende incluso más allá de los medicamentos tradicionales. Los sistemas actuales de inteligencia artificial participan también en el diseño de proteínas nuevas, incluyendo secuencias que no existen en la naturaleza. El objetivo puede ser crear enzimas, anticuerpos, proteínas terapéuticas u otras estructuras capaces de realizar funciones previamente especificadas.
Aquí la frontera empieza a desplazarse, porque ya no estamos utilizando exclusivamente una computadora para comprender la biología existente. Estamos empezando a utilizarla para proponer biología nueva.
La otra cara de la revolución
Esa capacidad introduce inevitablemente una pregunta incómoda. Si podemos utilizar inteligencia artificial para diseñar una proteína beneficiosa, ¿podrían utilizarse los mismos principios para diseñar una perjudicial?
La respuesta responsable no consiste en afirmar que una inteligencia artificial pueda actualmente crear por sí sola un agente biológico capaz de desencadenar una pandemia o destruir a la humanidad, pero tampoco sería responsable ignorar el problema. Los modelos generativos aplicados a biología presentan lo que se conoce como riesgo de doble uso: herramientas desarrolladas para investigación científica o aplicaciones terapéuticas pueden potencialmente utilizarse con otros objetivos.
Durante 2025 y 2026 esta cuestión comenzó a estudiarse de una manera mucho más concreta. Investigaciones del National Institute of Standards and Technology de Estados Unidos han señalado que los futuros sistemas de diseño biológico podrían generar secuencias suficientemente diferentes de las conocidas como para reducir la eficacia de mecanismos de detección basados exclusivamente en similitud de secuencia. Esto ha llevado a proponer una evolución hacia sistemas capaces de evaluar también la posible función biológica de una secuencia antes de permitir su síntesis.
Pero la misma investigación ofrece un contrapeso importante frente a interpretaciones apocalípticas. En experimentos realizados utilizando sustitutos biológicos seguros, los modelos actuales consiguieron generar proteínas estructuralmente similares a determinadas proteínas originales, pero conservar simultáneamente su función resultó considerablemente más difícil.
Diseñar una estructura plausible no equivale a diseñar un sistema biológico funcional. Pasar de una secuencia producida por una computadora a un agente biológico capaz de comportarse de una manera determinada continúa requiriendo conocimiento especializado, infraestructura experimental, recursos y numerosas etapas de validación.
El riesgo existe y merece anticipación, pero existe una enorme distancia entre reconocer ese riesgo y afirmar que actualmente una inteligencia artificial pueda crear a voluntad cualquier virus o toxina imaginable.
Las propias compañías empiezan a poner límites
Resulta significativo que las empresas que están desarrollando algunos de los modelos más avanzados también hayan comenzado a restringir determinadas capacidades biológicas.
OpenAI considera que sus modelos GPT-5.6 alcanzan el nivel de capacidad “High” en el dominio biológico y químico dentro de su Preparedness Framework, una clasificación que activa salvaguardas adicionales. Para herramientas especializadas en ciencias de la vida ha adoptado además mecanismos de acceso controlado para determinadas organizaciones y usos. Anthropic sigue una estrategia semejante con algunas de sus capacidades biológicas más avanzadas, limitando el acceso a organizaciones verificadas.
Estas decisiones no demuestran por sí mismas que los modelos actuales puedan producir agentes biológicos peligrosos. Sí muestran que sus propios desarrolladores consideran suficientemente plausible el riesgo de doble uso como para incorporar controles antes de que esas capacidades sean todavía mayores.
Aquí aparece una paradoja difícil de evitar: cuanto mejores sean estos sistemas para ayudar a diseñar una proteína terapéutica, encontrar un nuevo antibiótico o responder rápidamente frente a una futura pandemia, mayor podría ser también su capacidad para facilitar investigaciones biológicas potencialmente peligrosas. La misma tecnología puede fortalecer simultáneamente nuestra capacidad de crear y nuestra necesidad de controlar.
Los reguladores también han comenzado a prepararse
La inteligencia artificial aplicada al desarrollo farmacológico ya no es solamente una discusión académica. En enero de 2026, la Food and Drug Administration de Estados Unidos y la Agencia Europea de Medicamentos establecieron conjuntamente diez principios de buenas prácticas para la utilización de inteligencia artificial durante el desarrollo de medicamentos.
Entre ellos aparecen conceptos como diseño centrado en las personas, evaluación proporcional al riesgo, definición clara del contexto en el que se utilizará cada modelo, gobernanza de los datos, documentación, evaluación del rendimiento y supervisión durante todo el ciclo de vida.
Es una señal significativa de que la inteligencia artificial comienza a abandonar el terreno exclusivamente experimental para incorporarse progresivamente a procesos reales de investigación y desarrollo farmacológico. Los reguladores ya no están discutiendo solamente qué podría ocurrir en el futuro, sino cómo evaluar sistemas que empiezan a formar parte del presente.
¿Estamos ante una nueva revolución farmacológica?
Probablemente todavía sea demasiado temprano para afirmarlo. La inteligencia artificial ya transformó la predicción estructural de proteínas y está modificando diferentes etapas del descubrimiento farmacológico. Existen moléculas desarrolladas con una participación importante de IA que llegaron a ensayos clínicos y algunos programas han alcanzado fases avanzadas de desarrollo.
Al mismo tiempo, comenzamos a observar algo nuevo: sistemas de inteligencia artificial que no sólo predicen estructuras o proponen moléculas, sino que pueden utilizar herramientas científicas, diseñar experimentos y aprender de los resultados obtenidos en laboratorios automatizados. Sin embargo, todavía no existe evidencia suficiente para afirmar que estas plataformas produzcan sistemáticamente medicamentos más eficaces, más seguros o con una mayor probabilidad de aprobación. Esa demostración requerirá años.
Y quizá esa sea precisamente la etapa más interesante en la que nos encontramos. Durante décadas utilizamos computadoras fundamentalmente para almacenar, analizar y simular información biológica. Ahora empezamos a utilizarlas para generar hipótesis moleculares, proponer estructuras que antes no existían y participar en el propio ciclo experimental.
Quizás la verdadera revolución no consista en que una inteligencia artificial reemplace al químico, al biólogo o al médico, sino en algo menos espectacular y mucho más profundo: reducir progresivamente el enorme espacio de posibilidades que debemos explorar antes de encontrar una molécula que merezca ser probada en un ser humano y acelerar el ciclo mediante el cual una hipótesis científica se convierte en un experimento y ese experimento genera nuevo conocimiento.
AlphaFold 3 nos permite observar una parte de la biología con una precisión que hace pocos años parecía imposible. Los modelos generativos comienzan a utilizar ese conocimiento para proponer moléculas nuevas, mientras que los primeros agentes científicos empiezan a cerrar el círculo conectando esas predicciones con el laboratorio. Pero entre diseñar una estructura prometedora y disponer de un medicamento seguro y eficaz continúa existiendo un obstáculo formidable: la propia complejidad de la biología humana.
Mientras aprendemos a superar ese obstáculo aparece una segunda pregunta, quizá todavía más difícil: ¿qué límites deberemos establecer cuando las mismas herramientas que nos permiten comprender la biología comiencen también a permitirnos diseñarla?
Bibliografía y fuentes
- Abramson J, Adler J, Dunger J, et al. Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature. 2024;630:493–500.
- Artificial intelligence in drug discovery: perspectiva sobre el estado del campo. Nature Reviews Drug Discovery. 2026.
- Ensayo fase IIa de rentosertib (ISM001-055) en fibrosis pulmonar idiopática. Nature Medicine. 2025.
- Insilico Medicine. Insilico initiates Phase III clinical trial of rentosertib. 7 de julio de 2026. Fuente corporativa utilizada para documentar el anuncio del inicio de fase III.
- Isomorphic Labs. The Isomorphic Labs Drug Design Engine unlocks a new frontier. 2026. Fuente corporativa.
- OpenAI y Ginkgo Bioworks. GPT-5 lowers the cost of cell-free protein synthesis. 2026.
- OpenAI. Introducing GPT-Rosalind for life sciences research. 2026.
- Anthropic. Claude accelerates protein design. 2026.
- NIST. Beyond Sequence Similarity: The Case for Function-Based Screening of Nucleic Acid Synthesis. 2026.
- NIST. Experimental Evaluation of AI-Driven Protein Design Risks Using Safe Biological Proxies. 2026.
- FDA. Guiding Principles of Good AI Practice in Drug Development. 2026.
- Google DeepMind. AlphaFold 3 release history. La versión 3.0.3, publicada en junio de 2026, adoptó Apache 2.0 para el código.