

Durante décadas, uno de los grandes objetivos de la biología fue aprender a leer el código de la vida. Primero pudimos secuenciar genes y, con el tiempo, comenzamos a comprender mejor cómo esas secuencias producen proteínas, cómo se regula su actividad y de qué manera determinadas variantes pueden contribuir al desarrollo de enfermedades. En los últimos años, sin embargo, estamos entrando en una etapa diferente: además de leer e interpretar ese código, empezamos a disponer de herramientas capaces de modificarlo de manera dirigida.
CRISPR fue uno de los grandes saltos que hicieron posible esa transición. La inteligencia artificial puede convertirse en el siguiente.
La combinación entre ambas tecnologías ya está modificando la investigación en edición genética. Los algoritmos pueden ayudar a elegir dónde intervenir en el ADN, anticipar posibles modificaciones no deseadas, seleccionar mejores ARN guía y analizar las consecuencias funcionales de determinadas variantes. Más recientemente, los modelos generativos comenzaron incluso a diseñar nuevas proteínas de edición genética muy diferentes de las nucleasas naturales conocidas.
Este cambio se conecta con otra transformación que ya analizamos en Doctor Digital: el uso de AlphaFold 3 y modelos generativos para comprender interacciones moleculares y diseñar nuevas moléculas. La biología computacional dejó de utilizarse solamente para analizar datos obtenidos en el laboratorio y empieza también a participar en el diseño de nuevas intervenciones biológicas. Sin embargo, entre predecir una modificación y demostrar que funciona de manera segura existe todavía una enorme distancia. La inteligencia artificial puede reducir el espacio de búsqueda, orientar los experimentos y proponer soluciones novedosas, pero la biología continúa teniendo la última palabra.
Qué es CRISPR y por qué cambió la genética
CRISPR surgió en la naturaleza como parte de sistemas de defensa adaptativa presentes en bacterias y arqueas frente a virus y otros elementos genéticos invasores. Estos microorganismos pueden incorporar pequeños fragmentos del material genético del invasor y utilizarlos posteriormente como una especie de memoria molecular que permite reconocerlo.
El descubrimiento de que determinadas proteínas asociadas a CRISPR podían ser dirigidas mediante ARN hacia secuencias específicas de ADN permitió transformar ese mecanismo natural en una herramienta programable de ingeniería genética. Uno de los trabajos fundamentales fue publicado en Science en 2012 por Martin Jinek, Emmanuelle Charpentier, Jennifer Doudna y colaboradores, quienes demostraron que Cas9 podía ser programada mediante ARN para producir cortes en secuencias específicas de ADN.
El sistema experimental CRISPR-Cas9 utilizado habitualmente puede simplificarse en dos componentes principales: una proteína Cas9, capaz de cortar ADN, y un ARN guía que la dirige hacia una región determinada del genoma.
Cuando la secuencia del ARN guía reconoce suficientemente bien la región elegida, Cas9 puede producir una rotura de doble cadena. La célula intenta reparar posteriormente ese daño mediante sus propios mecanismos. Esa reparación puede aprovecharse para inactivar genes y, cuando se combina con plantillas de reparación u otras estrategias, también para introducir modificaciones dirigidas.
Con el tiempo aparecieron tecnologías considerablemente más sofisticadas. Los editores de bases utilizan componentes derivados de CRISPR combinados con otras enzimas para modificar determinadas bases sin necesidad de producir una rotura completa de las dos cadenas del ADN.
La edición primaria, conocida como prime editing, amplió todavía más las posibilidades. Utiliza una Cas9 modificada, una transcriptasa reversa y un ARN guía especializado denominado pegRNA, capaz de especificar tanto el sitio de edición como la modificación deseada. El trabajo original demostró inserciones, deleciones y los doce tipos posibles de sustitución puntual sin requerir una rotura de doble cadena ni una plantilla de ADN donante separada.
Por eso, describir CRISPR simplemente como unas “tijeras genéticas” comienza a resultar insuficiente. En realidad, se está convirtiendo en una plataforma programable de edición molecular y, cuanto más programable se vuelve una tecnología, mayor es el espacio en el que puede intervenir la inteligencia artificial.
El problema de elegir dónde editar
Saber que un determinado gen está relacionado con una enfermedad no significa que cualquier intervención sobre él vaya a resultar eficaz o segura. El genoma humano contiene aproximadamente 3.000 millones de pares de bases y muchas regiones presentan secuencias parcialmente similares. Un ARN guía diseñado para reconocer un sitio determinado puede, en determinadas condiciones, interactuar también con otras regiones.
Estas modificaciones no deseadas se conocen como efectos fuera del objetivo, o off-target. Algunas pueden carecer de consecuencias importantes, pero otras podrían alterar genes o regiones reguladoras relevantes.
Por eso, uno de los primeros campos en los que comenzaron a utilizarse técnicas de aprendizaje automático fue precisamente el diseño de los ARN guía. Los modelos pueden analizar grandes cantidades de experimentos previos y aprender qué características de una secuencia se asocian con una edición más eficiente. Al mismo tiempo, pueden recorrer el genoma buscando regiones suficientemente parecidas como para representar posibles sitios de unión no deseada.
Actualmente existen numerosos algoritmos destinados a estimar dos propiedades fundamentales: la eficiencia, es decir, la probabilidad de que la edición ocurra en el sitio buscado, y la especificidad, relacionada con la capacidad de evitar modificaciones en otras regiones.
Una revisión publicada en Nature Reviews Genetics, cuyo número impreso corresponde a 2026, describe precisamente el diseño de ARN guía, la predicción de actividad on-target y off-target, la ingeniería de proteínas editoras y el descubrimiento de nuevas enzimas como algunos de los principales campos en los que la inteligencia artificial está empezando a transformar la edición genética.
Esto no significa que una computadora pueda garantizar que una edición será segura. Las predicciones dependen de los datos utilizados para entrenar los modelos, del sistema CRISPR empleado, del tipo celular y del contexto biológico. Su función es más concreta y, al mismo tiempo, enormemente útil: permitir que los experimentos comiencen con candidatos mejor seleccionados.
Comprender qué ocurre cuando cambiamos el ADN
Elegir correctamente dónde editar es sólo una parte del problema. Antes de modificar una secuencia también necesitamos comprender qué consecuencias podría tener ese cambio.
Durante mucho tiempo resultó relativamente más sencillo interpretar algunas variantes que alteraban directamente la estructura de una proteína. Mucho más difícil ha sido comprender las variantes presentes en las regiones no codificantes del ADN, que constituyen la mayor parte del genoma y contienen numerosos elementos responsables de regular cuándo, dónde y con qué intensidad se expresan los genes.
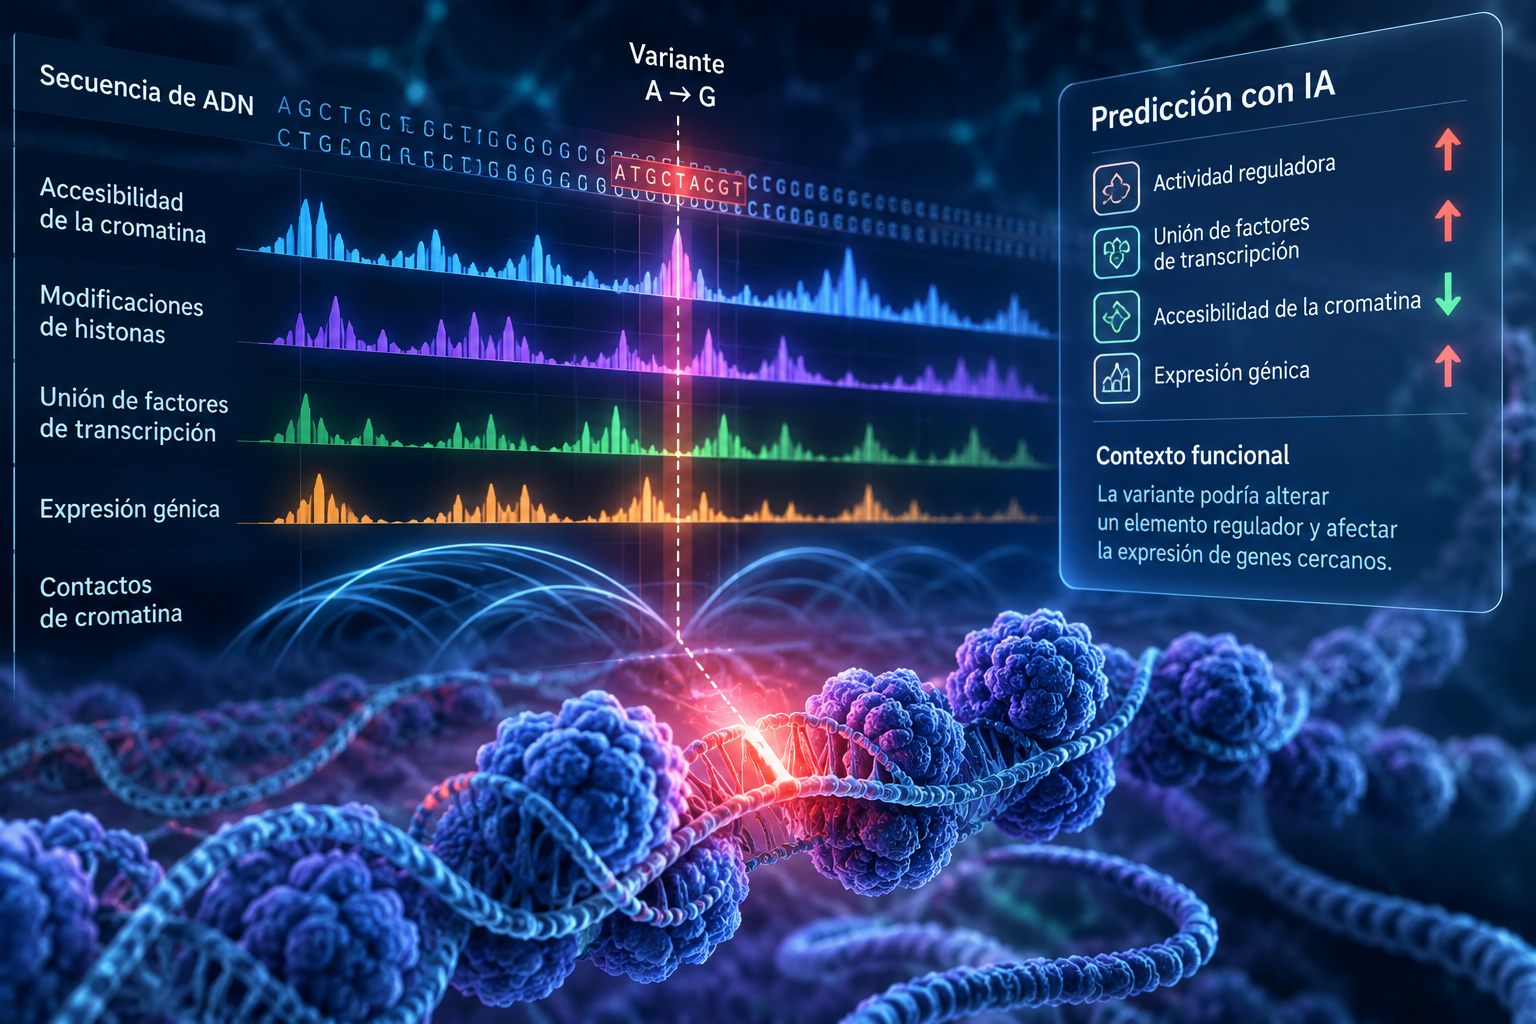
Aquí están apareciendo modelos capaces de aprender relaciones entre secuencia y función. Uno de los ejemplos más importantes es AlphaGenome, desarrollado por Google DeepMind y publicado en Nature en enero de 2026.
AlphaGenome puede analizar regiones de hasta aproximadamente un millón de pares de bases y generar predicciones sobre numerosos procesos regulatorios, entre ellos expresión génica, accesibilidad de la cromatina, modificaciones de histonas, unión de factores de transcripción, procesamiento del ARN y contactos de cromatina. En las evaluaciones publicadas, igualó o superó a los modelos externos comparados en 25 de 26 conjuntos de pruebas destinados a predecir el efecto de variantes.
AlphaGenome no es un sistema CRISPR y no modifica genes. Su relevancia para la edición genética aparece en una etapa anterior: puede ayudar a modelar cómo una determinada variante se relaciona con cambios funcionales en el genoma.
Esta distinción es importante. CRISPR proporciona una herramienta para realizar una modificación, pero decidir cuál modificación tiene sentido requiere comprender mejor el funcionamiento de las secuencias que queremos cambiar. La inteligencia artificial empieza así a conectar dos problemas que tradicionalmente se abordaban de manera separada: interpretar una variante y anticipar las consecuencias de modificarla.
La IA puede mejorar las herramientas CRISPR
La inteligencia artificial no sólo puede utilizarse para elegir mejores lugares de edición. También puede aplicarse a las propias proteínas que realizan esas modificaciones.
Las nucleasas Cas utilizadas habitualmente fueron descubiertas inicialmente en microorganismos. Cas9, Cas12 y otras proteínas forman parte de sistemas biológicos que evolucionaron durante millones de años. Una vez identificadas, los investigadores comenzaron a modificarlas mediante ingeniería molecular con distintos objetivos: mejorar su precisión, modificar las secuencias que pueden reconocer, reducir su tamaño o adaptarlas a nuevos sistemas de edición.
Los modelos generativos de proteínas ofrecen una estrategia complementaria. Al analizar enormes cantidades de secuencias, pueden aprender regularidades relacionadas con la estructura y la función de estas moléculas. De una manera conceptualmente similar a cómo un modelo de lenguaje aprende relaciones entre palabras y frases a partir de grandes corpus de texto, un modelo de proteínas puede aprender qué combinaciones de aminoácidos son compatibles con determinadas arquitecturas moleculares.
Una vez entrenado, el sistema puede generar secuencias nuevas, algunas de ellas considerablemente alejadas de las proteínas naturales conocidas. Esto conecta directamente CRISPR con la biología generativa, en la que la computadora deja de limitarse a clasificar o predecir propiedades de moléculas existentes y comienza también a proponer nuevas moléculas candidatas.
OpenCRISPR-1 y los editores diseñados por IA
Uno de los ejemplos más importantes de esta convergencia es OpenCRISPR-1.
El sistema fue presentado inicialmente como preprint en 2024 y posteriormente publicado en Nature el 30 de julio de 2025. En ese trabajo, investigadores de Profluent desarrollaron modelos de lenguaje de proteínas entrenados a partir de un conjunto que incluía más de un millón de operones CRISPR obtenidos mediante el análisis de aproximadamente 26 terabases de genomas y metagenomas.
Los modelos generaron millones de secuencias candidatas pertenecientes a distintas familias CRISPR-Cas. Varios de los editores obtenidos mostraron actividad y especificidad comparables o superiores a SpCas9, a pesar de encontrarse aproximadamente a 400 mutaciones de distancia de esta proteína en términos de secuencia.
Uno de ellos fue denominado OpenCRISPR-1. Los investigadores demostraron que podía editar ADN en células humanas y que también era compatible con sistemas de edición de bases.
El trabajo resulta especialmente relevante porque demuestra que los modelos generativos pueden explorar regiones del espacio de secuencias muy alejadas de las proteínas naturales conocidas y generar moléculas que conservan una función biológica útil. No es necesario afirmar que esas regiones “nunca fueron recorridas por la evolución”, algo que no podemos demostrar; basta con señalar que muchas de las secuencias propuestas son muy diferentes de las proteínas que conocemos actualmente.
El concepto es probablemente más importante que una proteína particular. Durante décadas, gran parte de la biotecnología siguió una estrategia basada en descubrir herramientas interesantes en la naturaleza y modificarlas posteriormente. La biología generativa introduce otra posibilidad: partir de determinadas propiedades deseadas y utilizar modelos computacionales para proponer moléculas candidatas.
Después será necesario sintetizarlas, probarlas y compararlas experimentalmente. La computadora no elimina el laboratorio, pero puede ayudar a decidir qué pequeñas regiones de un espacio molecular gigantesco merece la pena explorar.
La validación independiente de OpenCRISPR-1
Una cuestión especialmente importante en ciencia es saber si un resultado puede reproducirse fuera del grupo que desarrolló originalmente la tecnología.
En mayo de 2026, investigadores independientes publicaron en Genome Medicine una evaluación de OpenCRISPR-1 en diferentes sistemas de edición. El trabajo mostró que esta nucleasa podía mantener una actividad on-target comparable con SpCas9 en distintos loci y, al mismo tiempo, presentar una reducción importante de determinadas actividades off-target. Los investigadores también demostraron su utilización en estrategias de prime editing.
Esta validación independiente refuerza la idea de que los editores diseñados mediante modelos generativos no constituyen solamente una demostración computacional. Al menos algunos pueden funcionar como herramientas experimentales reales.
Esto no implica que OpenCRISPR-1 vaya a reemplazar a Cas9 ni que todos los editores generados por inteligencia artificial sean necesariamente mejores. La relevancia del ejemplo radica en demostrar que la generación computacional de nucleasas funcionales es técnicamente posible y puede producir moléculas con propiedades útiles.
De AlphaFold a la edición del genoma
Estas tecnologías suelen presentarse de manera separada, aunque en realidad comienzan a formar parte de un mismo proceso.
Modelos como AlphaFold ayudan a predecir estructuras de proteínas y, con nuevas generaciones de modelos, también determinadas interacciones moleculares. Los modelos genómicos intentan relacionar secuencias de ADN con regulación y función. Los algoritmos especializados en CRISPR pueden seleccionar ARN guía y anticipar posibles sitios fuera del objetivo, mientras que los modelos generativos de proteínas comienzan a diseñar nuevas herramientas moleculares.
CRISPR agrega a todo ese conocimiento una capacidad particularmente poderosa: intervenir físicamente sobre el genoma.
El resultado es una integración progresiva entre comprensión y manipulación. En un futuro, distintos modelos podrían contribuir a identificar una variante potencialmente patogénica, estimar cómo altera la función de un gen, comparar estrategias para corregirla y seleccionar una herramienta de edición adecuada. Otros sistemas podrían analizar posibles efectos no deseados o incluso proponer versiones modificadas de la propia proteína utilizada para realizar la intervención.
Cada etapa seguiría necesitando validación experimental, pero la cantidad de decisiones que pueden ser asistidas computacionalmente aumenta rápidamente. La inteligencia artificial deja así de ser solamente una herramienta para interpretar experimentos y empieza a participar en el proceso de diseño experimental.
¿Puede una IA diseñar una terapia genética?
Algunos de los componentes necesarios para hacerlo ya existen, aunque eso no significa que podamos automatizar el desarrollo completo de una terapia.
Los modelos pueden ayudar a identificar blancos, priorizar ARN guía, estimar riesgo off-target, interpretar variantes y optimizar proteínas. Sin embargo, convertir una estrategia de edición en un tratamiento eficaz exige resolver problemas que van mucho más allá de la secuencia del ADN.
Una modificación que funciona correctamente en una línea celular puede comportarse de manera diferente en otro tejido. También es necesario determinar cómo llevar el editor hasta las células adecuadas, durante cuánto tiempo permanecerá activo, qué proporción de células será modificada y cuál será la respuesta inmunológica del organismo.
Además, la biología no puede reducirse a una colección de secuencias independientes. Genes, proteínas, metabolismo, ambiente celular y señales provenientes de otros tejidos interactúan de manera permanente.
Por este motivo, otra frontera de investigación se orienta hacia los llamados modelos celulares virtuales, que intentan predecir cómo responderá una célula frente a determinadas perturbaciones. Su eventual integración con CRISPR podría mejorar nuestra capacidad para anticipar las consecuencias de una intervención, aunque todavía estamos hablando de un área de investigación emergente y no de una tecnología clínica establecida.
Menos experimentos, pero mejor seleccionados
Uno de los impactos más importantes de la inteligencia artificial sobre la biología probablemente no sea reemplazar los experimentos, sino ayudarnos a elegir cuáles vale la pena realizar.
El número de combinaciones posibles en biología molecular es extraordinariamente grande. Podemos diseñar miles de ARN guía contra un mismo conjunto de genes y millones de variantes diferentes de una proteína. Si además consideramos combinaciones entre mutaciones, contextos celulares y estrategias de administración, el espacio experimental se vuelve prácticamente imposible de recorrer mediante prueba y error.
Los modelos permiten reducir ese universo. A partir de millones de posibilidades pueden seleccionar algunos miles de candidatos y, posteriormente, priorizar un conjunto mucho menor para llevar al laboratorio.
Cuando esos experimentos generan nuevos datos, la información puede incorporarse nuevamente a los modelos y mejorar las predicciones futuras. Se forma así un ciclo en el que simulación y experimentación se retroalimentan continuamente.
Este mecanismo posiblemente sea uno de los cambios más profundos que introduzca la inteligencia artificial en la investigación biomédica. No elimina la experimentación; modifica la manera de decidir qué experimentar. En lugar de recorrer enormes espacios de posibilidades casi a ciegas, los investigadores pueden concentrar recursos sobre regiones previamente priorizadas mediante predicciones computacionales.
El límite sigue siendo la biología real
La velocidad con la que avanzan estos modelos puede producir una impresión engañosa. Generar una secuencia molecular plausible no demuestra que una proteína funcione, del mismo modo que predecir un bajo riesgo de efectos fuera del objetivo no garantiza que una edición vaya a comportarse exactamente como esperamos dentro de un organismo.
Los modelos de inteligencia artificial aprenden a partir de los datos disponibles. Si determinados tejidos, tipos celulares, mecanismos moleculares o poblaciones están insuficientemente representados, sus predicciones también pueden resultar menos fiables en esos contextos.
Además, incluso un modelo muy preciso trabaja necesariamente con una representación incompleta de la realidad. Ninguna simulación actual reproduce todas las interacciones que tienen lugar en una célula y mucho menos en un organismo completo.
La validación experimental continúa siendo, por lo tanto, el árbitro final. Los modelos pueden establecer prioridades, detectar patrones difíciles de reconocer y generar hipótesis novedosas, pero cada nueva herramienta de edición deberá demostrar experimentalmente que funciona y que lo hace con un margen de seguridad aceptable.
La diferencia entre predicción y demostración será cada vez más importante a medida que la inteligencia artificial pueda producir moléculas, estrategias de edición e hipótesis biológicas a una velocidad muy superior a nuestra capacidad para comprobarlas.
Una tecnología que también plantea límites éticos
La combinación entre inteligencia artificial y edición genética amplifica algunas de las preguntas que CRISPR ya había planteado por sí sola.
No es equivalente corregir una mutación en células somáticas de una persona con una enfermedad grave que introducir modificaciones heredables en embriones humanos. Tampoco tienen las mismas implicancias utilizar estas herramientas para tratar una enfermedad que emplearlas con el objetivo de modificar características humanas sin una indicación médica.
A medida que el diseño molecular se vuelva más accesible, será necesario discutir simultáneamente seguridad, regulación, acceso y mecanismos de supervisión. La inteligencia artificial puede disminuir algunas barreras técnicas, pero no resuelve las preguntas sociales y éticas relacionadas con aquello que consideramos aceptable modificar.
También existe un problema de distribución. Las terapias avanzadas pueden ser científicamente extraordinarias y, al mismo tiempo, resultar inaccesibles para gran parte de la población debido a su costo y complejidad. La verdadera dimensión de esta revolución no dependerá solamente de cuántas enfermedades puedan ser abordadas mediante edición genética, sino también de quiénes podrán beneficiarse de ella.
La capacidad técnica para realizar una modificación nunca determina por sí sola que debamos realizarla. Cuanto más poderosas se vuelvan estas herramientas, más importante será conservar esa distinción.
De comprender la vida a poder modificarla
La revolución genómica comenzó permitiéndonos leer el ADN. CRISPR proporcionó después una de las primeras herramientas verdaderamente programables para modificarlo y la inteligencia artificial está empezando a conectar ambas capacidades.
Los nuevos modelos genómicos intentan predecir qué significan determinadas secuencias y anticipar las consecuencias funcionales de ciertas variantes. Los algoritmos especializados en CRISPR ayudan a seleccionar dónde intervenir y a reducir el riesgo de modificaciones no deseadas. Al mismo tiempo, los modelos generativos empiezan a diseñar nuevas proteínas que podrían convertirse en herramientas moleculares de una próxima generación de editores.
Todavía estamos lejos de disponer de un sistema al que podamos describir una enfermedad y que automáticamente produzca una modificación genética segura y eficaz. Sin embargo, varias de las piezas necesarias para construir procesos mucho más asistidos por inteligencia artificial ya empiezan a existir.
Esto marca un cambio conceptual importante. La inteligencia artificial aplicada a la biología está dejando de ser únicamente una tecnología destinada a observar, clasificar y predecir fenómenos biológicos. También empieza a convertirse en una herramienta capaz de participar en el diseño de nuevas moléculas y nuevas intervenciones.
Este proceso forma parte de una transformación más amplia de la medicina y la investigación biomédica, en la que la inteligencia artificial empieza a integrarse en tareas clínicas, científicas y de gestión del conocimiento, aunque siempre con la necesidad de validación y supervisión humana.
Durante muchos años nos preguntamos hasta dónde podría llegar una computadora en su intento de comprender el código de la vida. La aparición de CRISPR, los modelos genómicos y la biología generativa agrega ahora una pregunta mucho más profunda: hasta dónde estaremos dispuestos a utilizar ese conocimiento para reescribirlo.
Fuentes y lecturas recomendadas
- Thomson T, Li G, Strilchuk A, et al. Harnessing artificial intelligence to advance CRISPR-based genome editing technologies. Nature Reviews Genetics. 2026;27:212–230. DOI: 10.1038/s41576-025-00907-1. Nature Reviews Genetics.
- Ruffolo JA, Nayfach S, Gallagher J, et al. Design of highly functional genome editors by modelling CRISPR–Cas sequences. Nature. 2025;645:518–525. DOI: 10.1038/s41586-025-09298-z. Nature.
- Hwang HY, Yi H, Gwon Y, et al. High-fidelity genome and prime editing enabled by the AI-designed OpenCRISPR-1. Genome Medicine. 2026;18:109. DOI: 10.1186/s13073-026-01682-2. Genome Medicine.
- Avsec Ž, Latysheva N, Cheng J, et al. Advancing regulatory variant effect prediction with AlphaGenome. Nature. 2026;649:1206–1218. DOI: 10.1038/s41586-025-10014-0. Nature.
- Anzalone AV, Randolph PB, Davis JR, et al. Search-and-replace genome editing without double-strand breaks or donor DNA. Nature. 2019;576:149–157. DOI: 10.1038/s41586-019-1711-4. Nature.
- Jinek M, Chylinski K, Fonfara I, et al. A programmable dual-RNA-guided DNA endonuclease in adaptive bacterial immunity. Science. 2012;337:816–821. DOI: 10.1126/science.1225829. Science.
- Rees HA, Liu DR. Base editing: precision chemistry on the genome and transcriptome of living cells. Nature Reviews Genetics. 2018;19:770–788. DOI: 10.1038/s41576-018-0059-1. PubMed.
- Advancing CRISPR with deep learning: a comprehensive review of models and databases. Molecular Therapy – Nucleic Acids. 2025;36:102691. DOI: 10.1016/j.omtn.2025.102691. ScienceDirect.


