La historia clínica electrónica digitalizó la burocracia. Ahora tiene que digitalizar la medicina

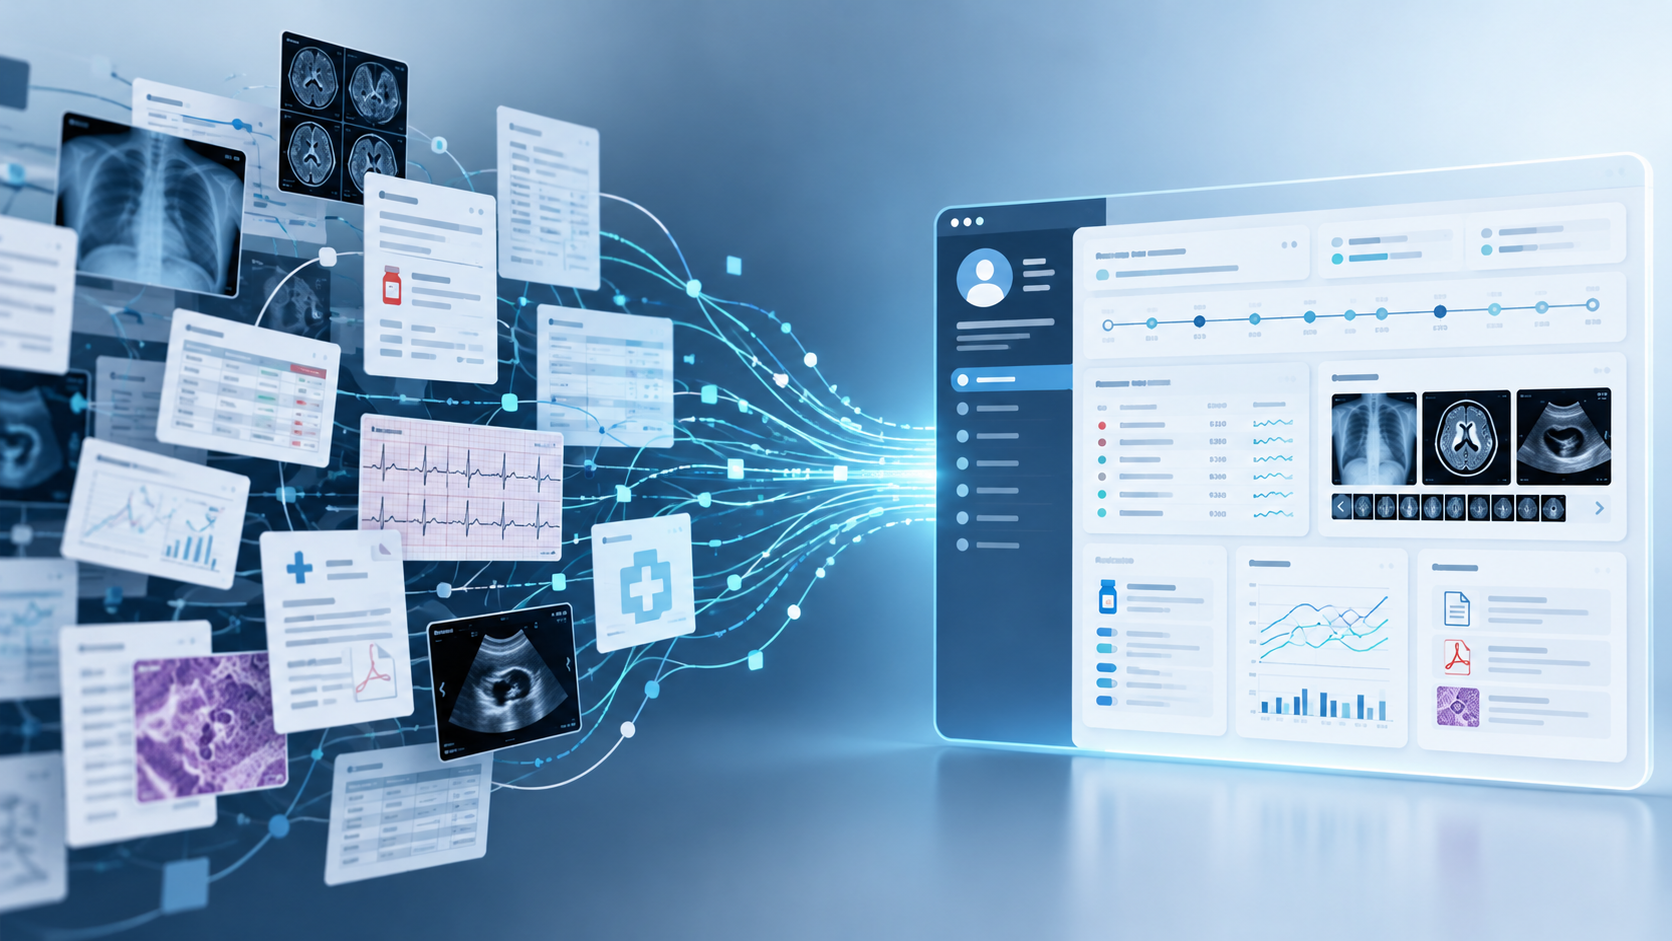
Integración de datos clínicos desde múltiples sistemas hacia una historia clínica electrónica unificada.

Digitalizamos historias clínicas, recetas, estudios y órdenes médicas, pero buena parte de esa información continúa distribuida entre sistemas que no se comunican. La próxima transformación de la medicina digital no consistirá simplemente en producir más datos, sino en conseguir que puedan acompañar al paciente, integrarse y convertirse nuevamente en conocimiento clínico.

La historia clínica electrónica fue concebida como una herramienta para simplificar la atención médica. Permitió abandonar buena parte del papel, acceder con mayor rapidez a estudios previos, conservar antecedentes durante años y reducir algunos de los problemas clásicos de las historias manuscritas. Sin embargo, la digitalización también produjo un efecto menos esperado: muchas veces no eliminó la burocracia, sino que la trasladó a la pantalla.

Cuando la burocracia también se vuelve digital

En Argentina, como ocurre en buena parte de Hispanoamérica, un profesional puede utilizar una plataforma para registrar la consulta, otra para solicitar estudios, diferentes sistemas para prescribir o validar medicamentos y portales independientes para consultar laboratorios, imágenes o autorizaciones. En tratamientos complejos pueden agregarse formularios de auditoría y sistemas específicos de los distintos financiadores, de modo que una misma información termina cargándose varias veces en entornos que no se comunican entre sí.

La receta electrónica es un buen ejemplo. Desde enero de 2025 constituye la modalidad general vigente para la prescripción de medicamentos en Argentina, con las excepciones previstas por la normativa, y las plataformas deben estar registradas ante el sistema nacional correspondiente. La regulación también procura que exista interoperabilidad entre prescriptores, repositorios, validadores y farmacias, pero que una prescripción sea electrónica no significa necesariamente que todo el proceso ocurra dentro del mismo entorno informático.

Cada plataforma puede funcionar correctamente por separado. El problema aparece cuando los sistemas no conocen lo que ocurrió en los demás, porque entonces el médico debe reconstruir información que ya existe, el paciente debe volver a trasladar documentos y la digitalización termina replicando la misma fragmentación del papel, solo que en distintas pantallas.

Digitalizar no es lo mismo que integrar

Una historia clínica electrónica cumple bastante bien una función básica: registrar lo ocurrido dentro de una institución. Conserva consultas, diagnósticos, tratamientos, resultados de laboratorio, procedimientos e informes, y permite que esa información permanezca disponible durante años. Sin embargo, almacenar información no significa necesariamente que esa información pueda utilizarse con facilidad.

Cuando un paciente acumula años de seguimiento, la historia puede contener cientos de documentos. Saber cuándo apareció por primera vez determinada lesión, por qué se suspendió un medicamento o cómo evolucionó un parámetro de laboratorio puede exigir revisar numerosos registros. La información está allí, pero no necesariamente organizada de una manera que permita comprender rápidamente lo ocurrido.

A esto se suma otro fenómeno propio de los sistemas electrónicos: la facilidad para copiar y reutilizar información. Un antecedente registrado una vez puede repetirse durante años; una lista de diagnósticos puede conservar enfermedades ya resueltas; un medicamento suspendido puede continuar apareciendo y una evolución puede reproducir párrafos completos de consultas anteriores. Se genera así una especie de inflación documental en la que la historia crece, pero no necesariamente mejora.

El desafío de la próxima generación de sistemas no será almacenar cada vez más datos, sino jerarquizarlos, relacionarlos y presentarlos de una manera clínicamente útil.

El verdadero problema es la fragmentación

En sistemas sanitarios como el nuestro, la dificultad no reside solamente en informatizar hospitales, consultorios y financiadores. El desafío es conseguir que esas plataformas puedan comunicarse y que la información pueda reutilizarse sin tener que ser reconstruida en cada punto del recorrido asistencial.

El paciente sigue trasladando informes impresos, archivos PDF, CDs, fotografías en el teléfono o carpetas con estudios realizados en diferentes lugares, mientras el médico puede verse obligado a ingresar nuevamente información que ya fue registrada en otro sistema. Los datos existen, pero muchas veces permanecen encerrados dentro de plataformas aisladas.

Por eso la verdadera transformación digital de la medicina no consiste simplemente en reemplazar formularios de papel por formularios electrónicos. Consiste en conseguir que la información pueda acompañar al paciente y ser interpretada allí donde resulte necesaria.

En Argentina ese objetivo ya forma parte del marco normativo. La Ley 27.706 creó el Programa Federal Único de Informatización y Digitalización de las Historias Clínicas y establece la construcción progresiva de un marco de interoperabilidad entre los sistemas públicos, privados y de la seguridad social. La implementación real es, naturalmente, mucho más difícil que escribir una ley, pero el objetivo está claramente definido.

La historia clínica debería poder reconstruir una historia

Pensemos en una situación frecuente. Un paciente consulta por primera vez en un servicio de oncología y tiene ocho años de antecedentes, varias cirugías, tratamientos realizados en diferentes instituciones, anatomías patológicas, estudios por imágenes y decenas de análisis. Para comprender qué ocurrió, alguien debe reconstruir esa cronología.

Una historia clínica más avanzada debería poder identificar los acontecimientos principales y organizarlos de manera comprensible: diagnóstico inicial, cirugía, anatomía patológica, tratamiento, período de seguimiento, aparición de una nueva lesión, biopsia de recaída y comienzo de una nueva línea terapéutica. No se trata simplemente de resumir documentos, porque el sistema necesita reconocer fechas, interpretar lenguaje médico, relacionar resultados y comprender que informes redactados de maneras diferentes pueden referirse al mismo proceso clínico.

Hasta hace pocos años, automatizar algo semejante era extremadamente difícil. Los grandes modelos de lenguaje modificaron considerablemente ese escenario porque permiten procesar grandes volúmenes de texto clínico, identificar relaciones y producir síntesis que antes requerían una revisión manual prolongada.

Una aplicación de la IA menos espectacular, pero probablemente más útil

Gran parte de la conversación pública sobre inteligencia artificial médica gira alrededor de una pregunta llamativa: si una IA puede diagnosticar mejor que un médico. Quizá no sea la pregunta más importante para la práctica cotidiana.

Una cuestión mucho más inmediata sería evaluar si puede ayudar a que un profesional no tenga que leer cien páginas para comprender qué ocurrió con su paciente. Una IA correctamente integrada a la historia clínica podría ordenar acontecimientos, resumir antecedentes, identificar tendencias en resultados de laboratorio, localizar información relevante dentro de documentos extensos y preparar una síntesis antes de la consulta.

También comienzan a utilizarse sistemas de documentación ambiental capaces de escuchar, con las autorizaciones correspondientes, la conversación entre médico y paciente y producir un borrador de la evolución. Estudios publicados en JAMA Network Open durante 2024 y 2025 encontraron asociaciones entre estas herramientas y una reducción de la carga percibida de documentación, aunque los diseños disponibles todavía tienen limitaciones y no permiten asumir que los resultados sean universales.

En este modelo, la IA no reemplaza la decisión clínica. Su función es reducir parte del trabajo mecánico necesario para reunir, organizar y documentar información que ya existe, lo que puede resultar mucho más relevante para la práctica cotidiana que intentar convertirla en un sustituto del razonamiento médico.

Para que eso funcione, los sistemas tienen que hablar el mismo idioma

Una inteligencia artificial puede ser extraordinariamente sofisticada, pero si solo conoce una fracción de la historia del paciente seguirá trabajando con una visión incompleta. Por eso la interoperabilidad es una condición previa para cualquier sistema que aspire a integrar información clínica de manera útil.

Interoperabilidad significa algo más que enviar un PDF entre dos computadoras. Implica que distintos sistemas puedan intercambiar información y comprenderla utilizando estructuras y significados comunes. Si un laboratorio informa una creatinina de 1,8 mg/dL, el sistema receptor debería ser capaz de reconocer que se trata de una determinación de creatinina, identificar la fecha, la unidad de medida y el paciente al que corresponde, en lugar de recibir únicamente un documento que un profesional tendrá que volver a interpretar manualmente.

Para conseguirlo hacen falta estándares capaces de representar la información de una manera predecible y compartida entre plataformas diferentes.

FHIR: un idioma común para los datos médicos

Uno de los estándares más importantes actualmente es FHIR, sigla de Fast Healthcare Interoperability Resources. FHIR es desarrollado por Health Level Seven International —HL7—, una organización internacional sin fines de lucro dedicada a crear y mantener estándares para el intercambio electrónico de información sanitaria.

HL7 no es una empresa de software ni una historia clínica comercial. Su función es definir reglas que puedan utilizar hospitales, gobiernos, desarrolladores y distintos proveedores tecnológicos, de modo que sistemas construidos por organizaciones diferentes puedan intercambiar información de manera coherente. El nombre Health Level Seven hace referencia históricamente a la capa de aplicaciones del modelo OSI de comunicaciones.

FHIR es la generación más moderna de estos estándares. En lugar de tratar toda la historia como un gran documento cerrado, representa la información mediante componentes denominados recursos, que pueden corresponder a pacientes, observaciones, medicamentos, procedimientos, diagnósticos y muchas otras entidades clínicas y administrativas.

La idea es relativamente sencilla. Un laboratorio no debería necesitar inventar una integración completamente distinta para cada hospital, ni un hospital debería depender exclusivamente de una determinada empresa para conectar su historia clínica con otras aplicaciones. Si diferentes sistemas utilizan estructuras compatibles, la información puede circular con mucha mayor facilidad.

FHIR no resuelve por sí mismo la interoperabilidad, porque también hacen falta terminologías clínicas comunes, identificación correcta de pacientes, reglas de seguridad y acuerdos entre organizaciones. Sin embargo, proporciona una parte fundamental del lenguaje necesario para que ese intercambio sea posible.

Argentina ya utiliza FHIR

FHIR tampoco es una tecnología exclusivamente estadounidense. La Red Nacional de Salud Digital argentina utiliza servicios web basados en tecnología REST y operaciones especificadas mediante FHIR, mientras que para la representación de conceptos clínicos incorpora SNOMED CT, una terminología internacional que permite codificar diagnósticos, síntomas, procedimientos, medicamentos y otras entidades clínicas.

En junio de 2026, el Ministerio de Salud realizó además el Encuentro Nacional de Salud Digital 2026, que incluyó una conectatón destinada a probar integraciones e intercambio de información clínica entre diferentes sistemas dentro de la Estrategia Nacional de Salud Digital 2025-2030.

Esto no significa que actualmente exista una historia clínica nacional única y completamente interoperable, ni que un médico pueda consultar automáticamente todo lo ocurrido con un paciente en cualquier institución argentina. Significa algo diferente y más realista: la interoperabilidad dejó de ser una idea teórica y ya forma parte de la arquitectura tecnológica y regulatoria hacia la que intenta avanzar el sistema argentino.

La historia pertenece al paciente

La interoperabilidad tiene además una dimensión jurídica. La Ley 26.529 establece expresamente que el paciente es titular de la historia clínica, mientras que las instituciones y profesionales tienen responsabilidades de guarda y custodia. La Ley 27.706 mantiene ese principio para la historia clínica electrónica y reconoce el derecho del paciente a conocer la información contenida en ella.

Esto conduce a una consecuencia lógica: si la información corresponde al paciente, debería existir una manera razonable de que pueda acompañarlo cuando cambia de institución, siempre dentro de las condiciones necesarias de seguridad y confidencialidad. La interoperabilidad no es, por lo tanto, solamente un problema informático, sino que también está relacionada con la continuidad asistencial y con la posibilidad efectiva de ejercer derechos sobre la propia información sanitaria.

La historia debe sobrevivir al programa que la contiene

Existe otra dimensión menos visible: la dependencia tecnológica respecto de un único proveedor, conocida como vendor lock-in. Una institución puede utilizar durante diez o quince años una plataforma determinada y acumular cientos de miles de registros, pero si posteriormente decide cambiar de sistema puede descubrir que trasladar toda esa información resulta extremadamente complejo.

Los estándares abiertos ayudan a reducir ese riesgo porque permiten separar, al menos conceptualmente, los datos de la aplicación concreta que los administra. Una historia clínica debería poder acompañar a una persona durante décadas, mientras que el software utilizado para almacenarla seguramente cambiará varias veces durante ese período.

El papel del software abierto

El código abierto ofrece otra alternativa dentro de este debate. No significa automáticamente que un sistema sea mejor, más seguro o más barato, porque una historia clínica requiere servidores, actualizaciones, copias de seguridad, políticas de seguridad, mantenimiento y personal capacitado independientemente del modelo de licencia.

Sin embargo, una plataforma abierta reduce algunas formas de dependencia absoluta respecto de un único proveedor y permite inspeccionar, modificar e integrar el sistema con mayor libertad. OpenEMR constituye un ejemplo conocido: el proyecto combina funciones de historia clínica y gestión médica y dispone de interfaces para integración, incluida una API basada en FHIR.

Su interés no está en presentarlo como una solución universal ni necesariamente superior a las alternativas comerciales, sino en mostrar que existen diferentes maneras de construir y gobernar una infraestructura clínica. Código abierto no significa infraestructura gratuita, pero sí supone otro modelo posible de control y evolución tecnológica.

¿Cómo podría ser la historia clínica hacia 2030?

Predecir cómo será una historia clínica dentro de cuatro años sería pretencioso, porque no existe una evolución única ni todos los sistemas sanitarios avanzarán a la misma velocidad. Sin embargo, muchas de las piezas necesarias ya existen y permiten imaginar una transformación bastante concreta.

La historia clínica podría dejar progresivamente de presentarse como una larga sucesión de documentos y comenzar a comportarse como una representación longitudinal del paciente. Al abrir el registro de una persona con diabetes, insuficiencia renal y cardiopatía, por ejemplo, el médico podría encontrar una síntesis actualizada de cada problema, la evolución de la función renal, los principales cambios terapéuticos, los últimos estudios relevantes y las decisiones pendientes. Los documentos originales seguirían disponibles, pero ya no sería necesario reconstruir manualmente toda la historia en cada consulta.

La conversación con el paciente también podría integrarse de otra manera. Los sistemas de documentación ambiental actuales ya demuestran que es posible generar borradores a partir del diálogo clínico, y una versión más madura podría relacionar esa conversación con los antecedentes existentes, distinguir qué información es nueva, detectar contradicciones y señalar qué datos requieren confirmación. El médico debería seguir revisando y validando el resultado, pero una menor proporción de la consulta podría quedar dedicada al teclado.

Los resultados de laboratorio podrían presentarse dentro de su evolución histórica y relacionarse con modificaciones terapéuticas. Una nueva tomografía podría quedar vinculada automáticamente con los estudios anteriores relevantes, mientras que la lista de medicamentos podría transformarse en una verdadera historia farmacológica que muestre cuándo comenzó cada tratamiento, cuándo cambió la dosis, por qué se suspendió y qué efectos adversos aparecieron.

En oncología, una arquitectura semejante podría relacionar anatomía patológica, biomarcadores moleculares, tratamientos y evolución de la enfermedad, además de ayudar a detectar potenciales criterios de elegibilidad para ensayos clínicos o advertir que un estudio solicitado nunca se realizó. Los datos generados fuera del hospital, como presión arterial domiciliaria, glucosa o determinados registros de dispositivos personales, también podrían incorporarse cuando aporten información clínicamente relevante.

Ese aumento de información introduce un problema adicional. La historia del futuro no deberá aprender solamente a incorporar datos, sino también a decidir cuáles merecen ocupar la atención del médico, porque un sistema que simplemente agregue nuevas fuentes sin jerarquizarlas podría terminar agravando exactamente el problema que intenta resolver.

¿Y quién escribió cada cosa?

La incorporación de IA plantea otra cuestión importante. Si un sistema resume una resonancia, otro genera un borrador de evolución y un tercero reorganiza antecedentes, meses después debería ser posible distinguir qué fue escrito originalmente por una persona y qué fue generado o modificado mediante inteligencia artificial.

NIST y HL7 trabajan actualmente sobre esta cuestión mediante AI Transparency on FHIR, una guía de implementación que busca representar dentro de FHIR cuándo existió participación de IA. La propuesta contempla desde una marca sencilla que indique esa intervención hasta registros de procedencia más detallados que puedan identificar el sistema utilizado, los participantes humanos y automáticos, las fuentes y otros elementos del proceso.

A octubre de 2026 continúa siendo un proyecto en desarrollo y revisión, no un estándar definitivo. Sin embargo, el principio probablemente resulte cada vez más importante: no alcanza con que una inteligencia artificial produzca un resultado aparentemente correcto, porque también debemos poder saber qué hizo, con qué información trabajó y quién validó el resultado.

Más interoperabilidad también exige más seguridad

Una historia capaz de integrar información procedente de múltiples instituciones resulta mucho más útil, pero también concentra datos extraordinariamente sensibles. Por eso la interoperabilidad no puede significar acceso indiscriminado.

Cuantos más sistemas puedan consultar información clínica, mayor será la importancia de la identidad digital, la autenticación, los permisos, la trazabilidad de los accesos y la posibilidad de auditar quién consultó o modificó determinados datos. El sistema del futuro tendrá que ser simultáneamente más abierto para permitir que la información circule y más estricto respecto de quién puede utilizarla; lejos de ser una contradicción, la seguridad es una condición necesaria para que una interoperabilidad amplia pueda ser aceptable.

La segunda revolución de la historia clínica

La primera revolución de la historia clínica electrónica consistió en reemplazar buena parte del papel por información digital. La segunda debería consistir en conseguir que esa información pueda utilizarse realmente, lo que obligará a resolver cuestiones menos espectaculares que construir una inteligencia artificial superhumana: interoperabilidad, identidad, terminologías comunes, seguridad, portabilidad, trazabilidad y calidad de los datos.

Argentina ya dispone de legislación específica, una Red Nacional de Salud Digital y una arquitectura que utiliza estándares como FHIR y SNOMED CT. Eso no significa que la interoperabilidad esté resuelta; la experiencia cotidiana demuestra cuánto falta todavía para que sistemas diferentes funcionen como partes de una misma infraestructura.

La inteligencia artificial puede acelerar el proceso porque permite interpretar y reorganizar enormes cantidades de lenguaje clínico, pero una IA aplicada sobre sistemas aislados seguirá trabajando con información aislada. Por eso el futuro de la historia clínica probablemente no dependa de una única tecnología revolucionaria, sino de conseguir que varias piezas funcionen juntas.

Durante las últimas décadas convertimos una enorme proporción de la medicina en datos. El desafío de la próxima etapa será conseguir que esos datos vuelvan a convertirse en una historia coherente y que, detrás de ella, podamos volver a ver al paciente.


Bibliografía

  1. Ley 26.529. Derechos del Paciente en su Relación con los Profesionales e Instituciones de la Salud. República Argentina.
  2. Ley 27.706. Programa Federal Único de Informatización y Digitalización de Historias Clínicas de la República Argentina. República Argentina.
  3. Ministerio de Salud de la Nación. Red Nacional de Salud Digital.
  4. Ministerio de Salud de la Nación. Receta electrónica y Registro Nacional de Plataformas Digitales Sanitarias.
  5. Health Level Seven International. FHIR — Fast Healthcare Interoperability Resources.
  6. Liu TL, Hetherington TC, Stephens C, et al. AI-Powered Clinical Documentation and Clinicians’ Electronic Health Record Experience: A Nonrandomized Clinical Trial. JAMA Network Open. 2024;7(9):e2432460.
  7. You JG, Dbouk RH, Landman A, et al. Ambient Documentation Technology in Clinician Experience of Documentation Burden and Burnout. JAMA Network Open. 2025;8(8):e2528056.
  8. National Institute of Standards and Technology. HL7 AI Transparency on Fast Healthcare Interoperability Resources (FHIR).
  9. OpenEMR Project. OpenEMR API / FHIR documentation.
Cuando el paciente consulta primero a la IA: ¿quién tiene la última palabra?

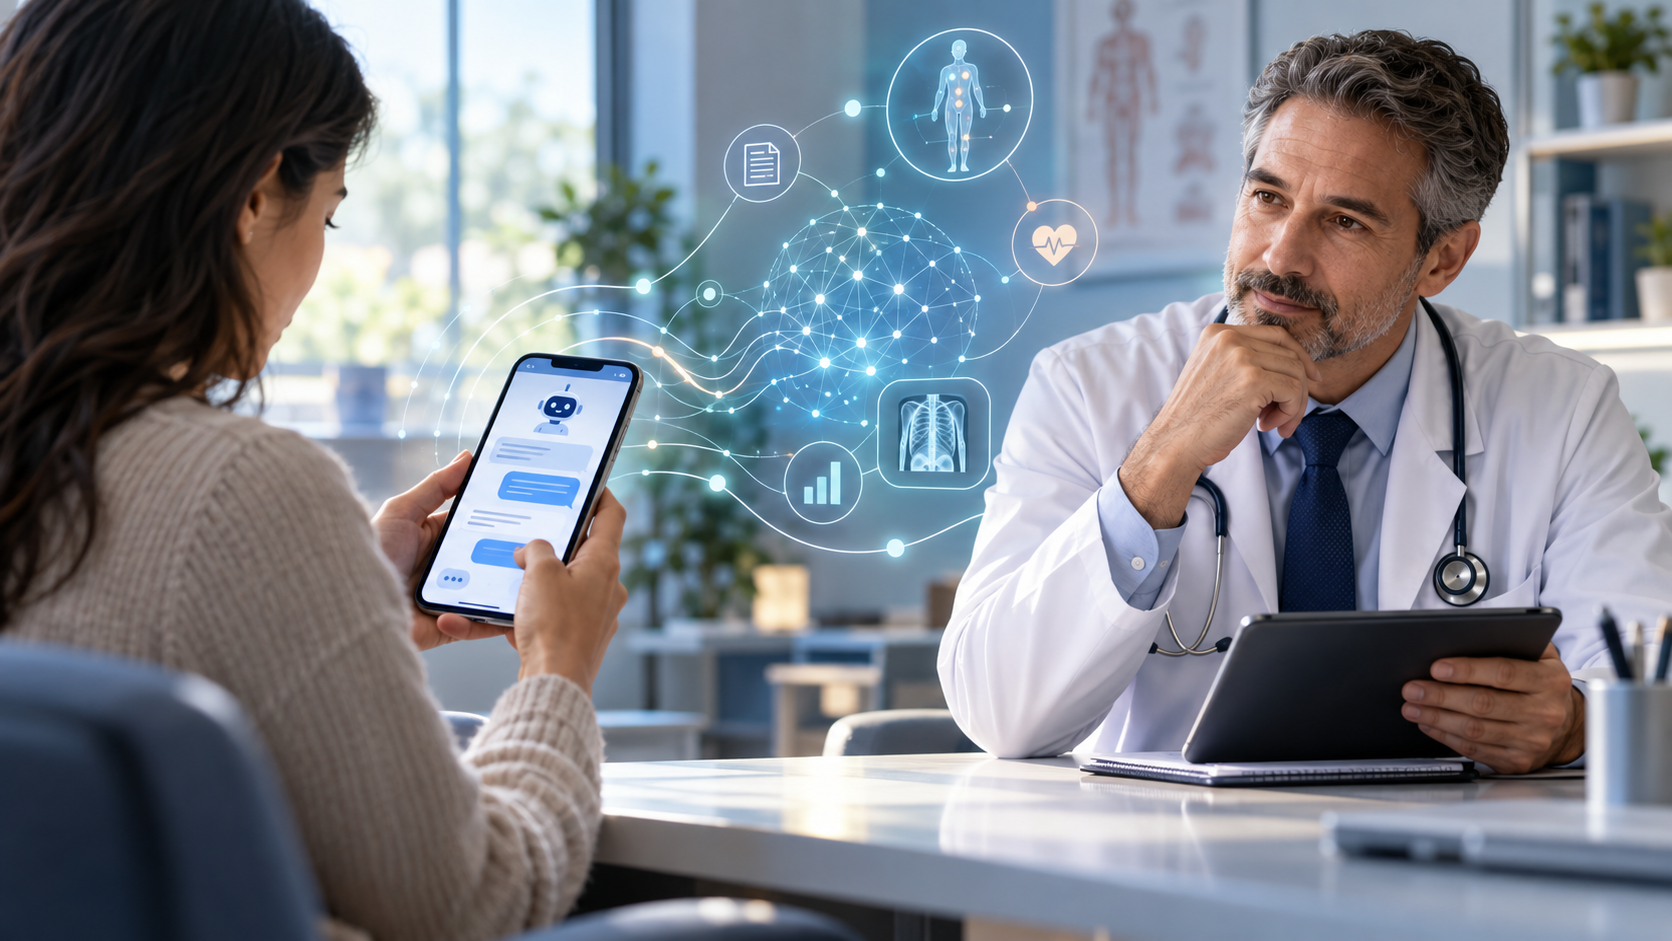
Paciente consulta una inteligencia artificial en su teléfono durante una consulta médica, representando la relación entre IA y médico-paciente.

Los pacientes ya utilizan inteligencia artificial para interpretar síntomas, revisar análisis, entender informes médicos y decidir si deberían consultar. Al mismo tiempo, el estado de Utah comenzó a experimentar con sistemas capaces de intervenir en renovaciones e incluso en algunas primeras prescripciones de medicamentos. Más que anunciar el reemplazo del médico, estos cambios plantean una pregunta diferente: ¿qué ocurre con la relación médico-paciente cuando una inteligencia artificial ya participó de la consulta antes de que el paciente entre al consultorio?

Durante años se volvió habitual que un paciente comenzara una consulta diciendo que había buscado sus síntomas en Google. Ahora aparece con creciente frecuencia una situación algo diferente: antes de consultar, la persona mantuvo una conversación con una inteligencia artificial, describió lo que le sucede, incorporó antecedentes, copió resultados de laboratorio o informes de imágenes y obtuvo una explicación organizada acerca de lo que podría estar ocurriendo.

La diferencia con una búsqueda tradicional no es menor. Un buscador ofrece páginas que el usuario debe seleccionar, comparar e interpretar; una inteligencia artificial conversa, recuerda lo dicho durante el intercambio, reformula una explicación si no fue comprendida y puede construir una hipótesis aparentemente coherente a partir de información dispersa. El paciente puede llegar entonces al consultorio no solamente con información, sino con una interpretación previa de su enfermedad y, en ocasiones, con una pregunta inevitable: «La IA me dijo que podría ser esto, ¿por qué usted piensa otra cosa?». En ese momento la IA deja de funcionar solamente como una fuente de información y empieza a ocupar, para el paciente, un lugar próximo al de una segunda opinión informal. Ese desplazamiento de autoridad es probablemente el cambio más importante: no sólo importa si la respuesta es correcta, sino cuánto peso se le concede antes de encontrarse con el médico.

La pregunta puede incomodar al médico, pero probablemente describa bastante bien una de las transformaciones que comenzaremos a ver con mayor frecuencia. La inteligencia artificial en la consulta médica no está modificando solamente el modo en que accedemos a información médica; también está alterando el punto de partida de la conversación entre el profesional y el paciente.

Utah: cuando la pregunta deja de ser solamente teórica

Ese desplazamiento de autoridad no ocurre solamente del lado de los pacientes. Es estado norteamericano de Utah comenzó a explorar, dentro de un regulatory sandbox, hasta qué punto determinados componentes del acto médico pueden delegarse a sistemas de inteligencia artificial bajo protocolos limitados, temporales y auditados. No se trata de una autorización general para que una IA ejerza medicina, sino de experimentos concretos que obligan a formular una pregunta que también aparece en el consultorio: ¿cuánto juicio médico estamos dispuestos a confiar a una máquina? [1]

Doctronic representa el ejemplo más conservador: interviene en renovaciones de tratamientos ya indicados. Puede procesar solicitudes correspondientes a medicamentos previamente prescriptos, pero no iniciar un tratamiento nuevo, modificar una dosis ni utilizar determinados medicamentos controlados. Lo relevante para este artículo es que el piloto continúa en su primera fase: cada solicitud requiere aprobación de un profesional médico y cualquier avance hacia una mayor autonomía necesita autorización expresa del regulador. [1,2]

La reacción del Utah Medical Licensing Board mostró justamente dónde aparece el conflicto. Once de sus catorce miembros recomendaron suspender el programa mientras se discutían sus implicancias, recordando que renovar una receta también puede ser una oportunidad para revisar efectos adversos, interacciones o cambios clínicos. La discusión, por lo tanto, no se limita a saber si el algoritmo puede hacerlo, sino a decidir qué parte del juicio médico puede delegarse y quién responde por la decisión. [3]

El límite comenzó a moverse un poco más cuando Utah autorizó un piloto capaz de intervenir también en determinadas primeras prescripciones. El caso es Nolla Health, activo desde el 5 de octubre de 2026: su sistema puede evaluar fotografías de adultos con acné leve o moderado y emitir primeras prescripciones o renovaciones para un conjunto limitado de tratamientos tópicos. El protocolo excluye, entre otras situaciones, acné grave, embarazo, lactancia e inmunosupresión. Tampoco estamos todavía frente a una prescripción completamente autónoma: durante la primera etapa, dos médicos habilitados en Utah revisan cada receta antes de que llegue a la farmacia, y cualquier reducción posterior de esa supervisión requiere autorización estatal. [1]

Lo relevante de Utah no es anunciar que la IA haya reemplazado al médico, sino mostrar que la cuestión de su autoridad clínica dejó de ser puramente teórica. Allí esa pregunta se intenta responder mediante protocolos, supervisión y auditorías; fuera de esos entornos regulados, en cambio, los pacientes ya realizan un experimento mucho más amplio cada vez que consultan a una IA antes de decidir si necesitan atención, antes de interpretar un estudio o antes de contrastar su explicación con la del profesional.

La consulta médica empieza antes de llegar al consultorio

Mientras los organismos regulatorios debaten estas experiencias, los pacientes ya están llevando adelante una transformación mucho más amplia y difícil de controlar. Un estudio publicado en Nature Health en 2026 analizó más de 500.000 conversaciones desidentificadas relacionadas con salud realizadas mediante Microsoft Copilot durante enero de ese año. Casi una de cada cinco incluía evaluación de síntomas personales o discusión de una posible enfermedad, y las consultas personales aumentaban durante la tarde y la noche, precisamente cuando disminuye el acceso habitual a profesionales sanitarios. [4]

Estos datos no permiten afirmar que una proporción determinada de la población utilice inteligencia artificial para autodiagnosticarse, porque analizan conversaciones dentro de una plataforma concreta y no una muestra representativa de usuarios. Sin embargo, muestran con claridad para qué se están utilizando estos sistemas: los pacientes no preguntan únicamente definiciones médicas, sino que describen síntomas, evalúan enfermedades posibles, buscan orientación y tratan de comprender qué deberían hacer a continuación.

Una revisión de alcance publicada en Journal of Medical Internet Research en septiembre de 2026 llegó a una conclusión compatible después de analizar 27 investigaciones empíricas. Entre las razones que favorecen el uso de inteligencia artificial para obtener información sanitaria aparecen la disponibilidad, la claridad de las explicaciones, la personalización y la posibilidad de recibir respuestas adaptadas a la pregunta concreta. Las principales barreras fueron, en cambio, las dudas sobre credibilidad, exactitud, confianza y facilidad para verificar las fuentes utilizadas. [5]

Esto ayuda a comprender por qué la comparación con el antiguo «Dr. Google» empieza a quedarse corta. La persona que busca información en Internet debe recorrer páginas diferentes y reconstruir por su cuenta una explicación. El chatbot puede integrar toda esa información dentro de una única conversación, responder preguntas sucesivas y adaptar el lenguaje al usuario, con una sensación de continuidad que se parece bastante más a una consulta que a una búsqueda.

¿Los pacientes están poniendo a prueba a sus médicos?

Una consecuencia previsible es que algunos pacientes utilicen la respuesta de la inteligencia artificial como una segunda opinión informal. Un estudio de métodos mixtos publicado en agosto de 2026 analizó específicamente esta situación en personas de China que habían utilizado IA generativa para interpretar síntomas o realizar una primera evaluación de su problema. Los participantes describieron una especie de «zona gris» previa a la consulta, en la que utilizaban estas herramientas para evaluar la gravedad aparente de sus síntomas, preparar preguntas y comprender posteriormente las explicaciones del médico. En la parte cuantitativa del estudio, una mejor valoración de la información proporcionada por la IA se asoció con mayor participación del paciente y, a través de una mejor comprensión o validación del diagnóstico, con mayor confianza en el médico. [6]

Conviene no convertir esas asociaciones en relaciones causales, porque se trató de un estudio observacional y realizado en un contexto cultural determinado. Sin embargo, resulta significativo que los datos no apoyen necesariamente la idea de una competencia permanente entre médico e inteligencia artificial. La IA también puede funcionar como intermediario informativo, especialmente cuando ayuda al paciente a comprender conceptos que durante una consulta breve pudieron quedar poco claros.

Otro estudio realizado en Polonia aporta el lado opuesto del fenómeno. En una encuesta en línea de 2026, 519 participantes informaron haber utilizado inteligencia artificial antes de una posible consulta médica y el 82,5% respondió negativamente cuando se les preguntó si habían comunicado ese uso al profesional. Los propios autores advierten que el estudio no confirmó que todos hubiesen efectivamente concretado la consulta, por lo que ese porcentaje no debe interpretarse como una tasa real de ocultamiento durante encuentros médicos. Aun con esa limitación, entre las razones declaradas para no mencionarlo aparecieron el temor a una reacción negativa del médico y la preocupación por poner en cuestión su autoridad. [7]

Paradójicamente, un ensayo aleatorizado anterior con un chequeador de síntomas encontró que los médicos casi nunca informaban que su autoridad hubiese sido cuestionada: ocurrió en el 1,1% de los pacientes que utilizaron la aplicación y en el 2,2% del grupo control. La impresión de que los pacientes inevitablemente llegan a «desafiar» al médico puede ser, por lo tanto, mucho mayor que la evidencia disponible. [8]

Una buena respuesta escrita no equivale a una buena consulta médica

Parte de la fascinación por estas herramientas se explica porque algunas respuestas son realmente buenas. En un conocido estudio publicado en JAMA Internal Medicine en 2023, profesionales sanitarios evaluaron 195 intercambios procedentes de un foro público y prefirieron las respuestas generadas por ChatGPT frente a las escritas por médicos en el 78,6% de las evaluaciones. Las respuestas del chatbot también recibieron puntuaciones superiores de calidad y empatía. [9]

El hallazgo fue importante, aunque muchas veces se lo interpretó más allá de lo que el estudio permitía concluir. Los investigadores compararon textos escritos frente a una pregunta ya formulada; no compararon consultas médicas completas, no evaluaron examen físico, seguimiento, solicitud de estudios ni resultados clínicos. Además, las respuestas del chatbot eran considerablemente más extensas que las de los médicos, algo que puede influir sobre la percepción de detalle y empatía.

Los modelos generativos pueden producir explicaciones claras, extensas y comunicativamente atractivas, lo que abre posibilidades interesantes para educación y comunicación sanitaria. Sin embargo, producir una respuesta convincente cuando toda la información ya está disponible es solamente una parte del razonamiento clínico. Antes de responder correctamente es necesario determinar qué información falta, cuál es relevante y qué preguntas deben hacerse para obtenerla.

En ese punto aparece una diferencia fundamental entre responder una consulta escrita y atender a una persona. El profesional no solamente recibe información: dirige la anamnesis, identifica contradicciones, observa signos que el paciente puede no considerar importantes, realiza un examen físico, integra antecedentes y utiliza la evolución temporal de los síntomas para modificar las probabilidades diagnósticas.

El problema puede no estar en lo que sabe la IA, sino en lo que el paciente consigue contarle

Un ensayo preregistrado publicado en Nature Medicine en febrero de 2026 mostró de manera particularmente clara esta diferencia. Los investigadores evaluaron a 1.298 participantes frente a diez escenarios médicos, comparando la asistencia de GPT-4o, Llama 3 y Command R+ con la posibilidad de utilizar recursos convencionales. Cuando los modelos recibían directamente toda la información de los casos, identificaban correctamente condiciones relevantes en el 94,9% de las ocasiones. Sin embargo, cuando eran personas reales quienes debían interactuar con esos mismos modelos, identificaban una condición relevante en menos del 34,5% de los casos y elegían adecuadamente la conducta a seguir en menos del 44,2%. Los participantes asistidos por los modelos no obtuvieron mejores resultados que el grupo control. [10]

El dato es particularmente importante porque muestra que las pruebas tradicionales pueden sobreestimar la utilidad clínica real de una inteligencia artificial. Un modelo puede resolver perfectamente una viñeta estructurada y fracasar cuando debe obtener la información necesaria mediante una conversación con alguien que no sabe qué elementos son importantes para el diagnóstico.

Otro experimento preregistrado publicado en Nature Health durante 2026 profundizó esta cuestión. Quinientos participantes debían describir síntomas simulados de enfermedades frecuentes y fueron asignados a creer que estaban comunicándose con un chatbot o con un médico. Los informes de quienes creían estar hablando con la IA fueron aproximadamente un 8% menos adecuados para una evaluación inicial de urgencia, un resultado que posteriormente también fue confirmado mediante evaluación de médicos. [11]

La anamnesis, por lo tanto, no consiste simplemente en escuchar la historia que alguien decide contar. Una parte esencial del trabajo médico consiste en descubrir qué información todavía no fue mencionada y formular la pregunta que permita obtenerla. Ésa puede ser una de las limitaciones más importantes de los chatbots utilizados de manera espontánea para autodiagnóstico.

Chequeadores de síntomas: pueden ayudar, pero no todos sirven para lo mismo

Los chequeadores de síntomas existen desde mucho antes de la actual generación de modelos lingüísticos y su historia obliga a ser prudentes. Una revisión sistemática publicada en 2023 encontró una gran variabilidad entre herramientas, con precisión diagnóstica generalmente baja y resultados también heterogéneos para el triaje. Los propios autores concluyeron que la evidencia disponible todavía no justificaba asumir que estas aplicaciones fueran suficientemente precisas para una adopción generalizada sin validación adicional. [12]

La nueva generación de sistemas conversacionales puede modificar parte de ese panorama. Un ensayo publicado el 5 de octubre de 2026 en Nature Health asignó aleatoriamente a 2.400 adultos sin formación médica a utilizar un chatbot especializado en patología respiratoria basado en GPT-4o o búsquedas convencionales en Internet para resolver casos simulados. En el análisis principal, el grupo que utilizó el chatbot obtuvo una precisión global estimada del 70,0%, frente al 55,4% del grupo que utilizó búsquedas web. La ventaja fue más evidente para reconocimiento diagnóstico que para decisiones de triaje y, como correctamente señalan los autores, se trató de escenarios simulados: el estudio no demuestra todavía que utilizar ese sistema reduzca errores diagnósticos, internaciones o complicaciones en pacientes reales. [13]

Esto obliga a abandonar una pregunta demasiado general como «¿funcionan los chequeadores de síntomas?». La respuesta dependerá de qué herramienta se utilice, con qué objetivo, en qué población y para qué tipo de problema. Una inteligencia artificial puede resultar muy útil para explicar qué significa un término de un informe, organizar antecedentes, preparar preguntas para una consulta o reconocer determinados signos de alarma; es mucho más riesgoso convertir esa capacidad en la certeza de que puede responder confiablemente «qué enfermedad tengo».

Entre la tranquilidad y la ansiedad: el problema de buscar certeza sin límite

Existe además una dimensión psicológica que no debería subestimarse. Una inteligencia artificial está disponible a cualquier hora, acepta preguntas sucesivas y puede continuar explorando una preocupación prácticamente sin límite. Para una persona que busca comprender un problema esto puede ser tranquilizador, pero para otra que intenta obtener certeza absoluta acerca de una enfermedad puede transformarse en un circuito de comprobación permanente.

La evidencia disponible no permite afirmar que los chequeadores de síntomas necesariamente aumenten la ansiedad. En un ensayo multicéntrico aleatorizado publicado en 2025, pacientes de baja complejidad que consultaban servicios de urgencias utilizaron el chequeador de síntomas Ada antes de encontrarse con el médico. La ansiedad media no aumentó significativamente en comparación con la atención habitual y tampoco se deterioraron la confianza ni la satisfacción con la relación médico-paciente. Sin embargo, el efecto individual fue heterogéneo: el 35,2% informó mayor ansiedad después de utilizar la aplicación, mientras que el 26,1% presentó una disminución superior a cinco puntos en la escala utilizada. [8]

Los chatbots generativos incorporan además una característica que los chequeadores tradicionales no tenían con la misma intensidad: permiten repreguntar indefinidamente alrededor de una posibilidad poco probable. Una persona puede comenzar consultando por cefalea, recibir una lista razonable de diagnósticos posibles y concentrarse después en la alternativa más grave. A partir de allí puede preguntar por sus síntomas iniciales, sus formas atípicas, la posibilidad de que un estudio normal no la descarte y cualquier otro elemento que mantenga abierta la hipótesis. La conversación puede terminar construyendo una narrativa cada vez más centrada en una enfermedad que originalmente era poco probable.

Un artículo de perspectiva publicado en npj Digital Medicine en 2026 propone precisamente que la disponibilidad constante y la capacidad de brindar respuestas tranquilizadoras podrían, en personas predispuestas a determinados trastornos de ansiedad o conductas compulsivas de comprobación, reforzar ciclos de búsqueda repetitiva de certeza. Los autores presentan un modelo teórico basado en mecanismos conocidos de ansiedad y trastorno obsesivo-compulsivo; no demuestran que los chatbots provoquen estos trastornos ni permiten estimar con qué frecuencia ocurre ese fenómeno. [14]

A esta incertidumbre psicológica se suma un problema de seguridad más directo. Un estudio de red teaming dirigido por médicos evaluó 888 respuestas producidas por cuatro chatbots a 222 preguntas médicas planteadas desde la perspectiva de pacientes. Dependiendo del modelo, entre el 21,6% y el 43,2% de las respuestas fueron consideradas problemáticas, y entre el 5% y el 13% se clasificaron como inseguras. Esto no significa que una proporción equivalente de todas las respuestas médicas que producen los chatbots sea peligrosa, porque el estudio fue diseñado específicamente para detectar fallas, pero demuestra que una respuesta fluida y convincente no garantiza seguridad clínica. [15]

La relación médico-paciente no desaparece, pero probablemente tenga que cambiar

Durante mucho tiempo la medicina estuvo basada en una gran asimetría de información. El paciente describía lo que sentía y el profesional disponía de conocimientos y recursos difíciles de obtener fuera del sistema sanitario. Internet redujo esa distancia y la inteligencia artificial puede reducirla todavía más porque no solamente proporciona información, sino que la interpreta, resume y adapta al lenguaje de cada persona.

Esto no tiene por qué deteriorar la relación médico-paciente. El paciente que comprende mejor su enfermedad puede participar con más criterio en una decisión compartida, recordar preguntas importantes y reconocer mejor las incertidumbres del tratamiento. El conflicto aparece cuando una respuesta probabilística se interpreta como diagnóstico, cuando una explicación aparentemente precisa fue construida con información incompleta o cuando el médico percibe toda consulta previa a una IA como una amenaza a su autoridad.

Probablemente resulte más útil incorporar esa información a la consulta. Preguntar «¿buscaste información sobre esto o se lo consultaste a alguna inteligencia artificial?» puede convertirse en una parte razonable de la anamnesis, del mismo modo que preguntamos qué medicamentos utiliza una persona o qué opinión recibió de otro profesional. Saber qué diagnóstico teme el paciente, qué explicación recibió y qué información proporcionó al chatbot permite comprender mejor desde dónde comienza la conversación.

La inteligencia artificial también eleva las expectativas. Un chatbot responde inmediatamente, puede explicar una misma cuestión cinco veces con palabras diferentes y nunca parece apurado. Frente a sistemas sanitarios con consultas breves y profesionales sobrecargados, esa disponibilidad puede resultar subjetivamente más satisfactoria incluso cuando la información no sea clínicamente superior. El desafío para la medicina, por lo tanto, no consistirá simplemente en demostrar que el médico conoce más datos, sino en preservar aquello que convierte la información en atención clínica: obtener una historia adecuada, examinar, interpretar el contexto, reconocer incertidumbre, decidir cuándo intervenir y asumir responsabilidad por las consecuencias.

Utah está explorando hasta dónde una inteligencia artificial puede participar formalmente de decisiones que antes estaban reservadas al profesional, mientras millones de interacciones informales entre pacientes y sistemas generativos ya están modificando el camino que conduce hasta la consulta. Quizás por eso la pregunta del futuro no sea si debemos creerle al médico o a la inteligencia artificial. Será aprender para qué puede ser útil cada uno, cuáles son los límites de sus respuestas y quién debe asumir finalmente la responsabilidad cuando una decisión afecta la salud de una persona.


Bibliografía

  1. Utah Department of Commerce, Office of Artificial Intelligence Policy. Authorized AI Pilots. Estado y condiciones de los programas Doctronic, August AI y Nolla Health. Consultado el 7 de octubre de 2026.
  2. Utah Department of Commerce, Office of Artificial Intelligence Policy. Doctronic AI Regulatory Mitigation Agreement. Documentación oficial del piloto y sus fases de supervisión.
  3. Utah Medical Licensing Board. Letter regarding Doctronic AI Regulatory Mitigation Pilot. 20 de abril de 2026.
  4. Costa-Gomes B, Tolmachev P, Taysom E, et al. Public use of a generalist LLM chatbot for health queries. Nature Health. 2026;1:689-696. doi:10.1038/s44360-026-00117-x.
  5. Alon L, Levkovich I. Consumer and Patient Health Information Seeking With Generative AI Tools: Scoping Review of Facilitators and Barriers. J Med Internet Res. 2026;28:e93944. doi:10.2196/93944.
  6. Ding W, Wang J. Generative Artificial Intelligence (AI)–Assisted Self-Diagnosis and the Patient-Physician Relationship: Mixed Methods Study of Calibration, Participation, and Trust. J Med Internet Res. 2026;28:e95072. doi:10.2196/95072.
  7. Wójcik S, Rulkiewicz A, Domienik-Karłowicz J. Generative AI use before medical visits: disclosure-item responses, trust, and care-seeking behaviors in a cross-sectional social-media survey in Poland. Front Digit Health. 2026;8:1933451. doi:10.3389/fdgth.2026.1933451.
  8. Schmieding ML, Kopka M, Bolanaki M, et al. Impact of a Symptom Checker App on Patient-Physician Interaction Among Self-Referred Walk-In Patients in the Emergency Department: Multicenter, Parallel-Group, Randomized, Controlled Trial. J Med Internet Res. 2025;27:e64028. doi:10.2196/64028.
  9. Ayers JW, Poliak A, Dredze M, et al. Comparing Physician and Artificial Intelligence Chatbot Responses to Patient Questions Posted to a Public Social Media Forum. JAMA Intern Med. 2023;183(6):589-596. doi:10.1001/jamainternmed.2023.1838.
  10. Bean AM, Payne RE, Parsons G, et al. Reliability of LLMs as medical assistants for the general public: a randomized preregistered study. Nature Medicine. 2026;32:609-615. doi:10.1038/s41591-025-04074-y.
  11. Reis M, Reis F, Kim YJ, et al. Reduced symptom reporting quality during human-chatbot versus human-physician interactions. Nature Health. 2026. doi:10.1038/s44360-026-00116-y.
  12. Riboli-Sasco E, El-Osta A, Alaa A, et al. Triage and Diagnostic Accuracy of Online Symptom Checkers: Systematic Review. J Med Internet Res. 2023;25:e43803. doi:10.2196/43803.
  13. Liang J, Wang Y, Ni J, et al. Accuracy of a respiratory assessment chatbot in a nationwide messaging system for layperson diagnosis and triage: a randomized preregistered study. Nature Health. 2026. doi:10.1038/s44360-026-00189-9.
  14. Golden A, Aboujaoude E. A transdiagnostic model for how general purpose AI chatbots can perpetuate OCD and anxiety disorders. npj Digital Medicine. 2026;9:343. doi:10.1038/s41746-026-02531-7.
  15. Draelos RL, Afreen S, Blasko B, et al. Large language models provide unsafe answers to patient-posed medical questions. npj Digital Medicine. 2026;9:241. doi:10.1038/s41746-026-02428-5.

Biología generativa: cuando la IA empieza a diseñar vida

Biología generativa e inteligencia artificial: del código genético al diseño de proteínas y sistemas celulares

Durante buena parte de la historia de la biología moderna, el desafío fue aprender a leer. Primero secuenciamos genes; después comenzamos a relacionar esas secuencias con proteínas, estructuras y funciones. En los últimos años, herramientas como AlphaFold mostraron hasta qué punto la inteligencia artificial podía ayudarnos a comprender la arquitectura molecular de la vida. CRISPR dio un paso diferente: permitió modificar de manera dirigida parte de ese código.

Pero una nueva generación de modelos plantea una pregunta todavía más profunda. ¿Qué ocurre cuando una inteligencia artificial deja de limitarse a interpretar o modificar la biología existente y comienza a proponer moléculas, proteínas y secuencias que nunca existieron en la naturaleza?

Ese es el territorio de la biología generativa. El término reúne tecnologías diferentes, pero todas comparten una idea con la IA generativa que produce textos o imágenes: aprender regularidades a partir de enormes cantidades de datos y utilizarlas para generar algo nuevo. La diferencia es que aquí el resultado no es una frase ni una fotografía. Puede ser la secuencia de una proteína, un fragmento de ADN o, al menos en principio, una parte cada vez mayor de un sistema biológico.

La comparación debe utilizarse con cautela. Una imagen generada puede evaluarse inmediatamente en una pantalla. Una secuencia biológica puede parecer perfectamente plausible para un modelo y, sin embargo, no plegarse correctamente, no funcionar dentro de una célula, resultar tóxica o producir efectos inesperados. La biología está sometida a restricciones físicas, químicas y evolutivas que no desaparecen porque un algoritmo sea capaz de generar una secuencia convincente. Entre diseñar algo en una computadora y demostrar que funciona en un sistema vivo continúa existiendo una distancia experimental considerable.

De predecir proteínas a diseñarlas

El cambio puede entenderse observando lo ocurrido con las proteínas. AlphaFold convirtió la predicción de estructuras en una herramienta extraordinariamente poderosa, pero su pregunta fundamental era: dada una secuencia, ¿qué estructura probablemente adopte esta proteína? Los modelos generativos permiten invertir parcialmente el problema. Podemos comenzar con una estructura, una superficie de unión o determinada función y pedir al sistema que explore qué proteínas podrían cumplirla.

RFdiffusion fue uno de los hitos de esta transición. Publicado en Nature en 2023, adaptó el concepto de los modelos de difusión —popularizados por la generación de imágenes— al diseño de estructuras proteicas. El sistema produjo proteínas de novo, ensamblajes y moléculas diseñadas para unirse a blancos determinados, y numerosos diseños fueron sintetizados y evaluados experimentalmente. No se trataba simplemente de recuperar proteínas existentes de una base de datos, sino de explorar regiones del espacio molecular que la evolución conocida no había recorrido de esa manera.

Desde entonces, el campo avanzó rápidamente. Una revisión publicada en Nature en 2026 sostiene que algunos problemas clásicos del diseño de nuevas estructuras, ensamblajes y proteínas de unión están cerca de dejar de ser principalmente problemas de “cómo diseñar” para convertirse en problemas de “qué conviene diseñar”. La afirmación no significa que cualquier proteína imaginable pueda obtenerse a voluntad. Diseñar enzimas complejas, interruptores moleculares, sistemas con múltiples estados o verdaderas nanomáquinas continúa siendo considerablemente más difícil. Pero la frontera se desplazó.

Una proteína que la evolución nunca produjo

ESM3 ofrece otro ejemplo particularmente ilustrativo. Este modelo fue desarrollado para trabajar simultáneamente con secuencia, estructura y función de proteínas. En un trabajo publicado en Science en 2025, los investigadores le pidieron generar proteínas fluorescentes y sintetizaron algunas de sus propuestas. Entre ellas encontraron una proteína fluorescente funcional cuya secuencia presentaba apenas un 58 % de identidad con la proteína fluorescente conocida más cercana.

Los autores estimaron que esa distancia sería comparable a aproximadamente 500 millones de años de divergencia evolutiva. Es importante entender qué significa esa comparación: la computadora no reprodujo literalmente 500 millones de años de evolución. Se trata de una estimación basada en la distancia entre secuencias. Lo relevante es más concreto y, quizá, más interesante: un modelo entrenado con diversidad biológica fue capaz de proponer una proteína funcional muy distante de las secuencias naturales conocidas y, al sintetizarla, el laboratorio confirmó que efectivamente era fluorescente.

El mismo principio comienza a extenderse a las herramientas con las que intervenimos la biología. Como vimos al analizar CRISPR e inteligencia artificial, OpenCRISPR-1 mostró que un modelo generativo podía proponer un editor CRISPR-Cas funcional y muy alejado en secuencia de las Cas9 naturales de referencia. En células humanas mostró actividad de edición y compatibilidad con edición de bases. Aquí interesa menos repetir aquel experimento que advertir el cambio de escala: la inteligencia artificial ya no sólo selecciona entre herramientas biológicas existentes, sino que comienza a explorar versiones nuevas de esas herramientas.

¿Puede una IA escribir ADN?

El siguiente nivel es considerablemente más complejo. Las proteínas suelen contener cientos de aminoácidos; los genomas pueden contener desde cientos de miles hasta miles de millones de bases y su funcionamiento depende de relaciones que abarcan enormes distancias dentro de la secuencia. Modelar un genoma exige aprender regularidades relacionadas no sólo con genes individuales, sino también con regiones regulatorias, organización cromosómica, expresión y relaciones entre diferentes elementos del ADN.

Evo 2 representa uno de los intentos más ambiciosos de llevar los modelos generativos a esa escala. Publicado en Nature en 2026, fue entrenado con aproximadamente nueve billones de pares de bases procedentes de organismos de todos los dominios de la vida y puede trabajar con contextos de hasta un millón de nucleótidos. El modelo mostró capacidad para predecir efectos de variantes genéticas y generar secuencias largas con características semejantes a las observadas en genomas naturales.

Evo 2 puede producir secuencias a escala genómica correspondientes a distintos dominios de la vida, y sus autores demostraron además experimentalmente algunos diseños regulatorios generados con ayuda del modelo. Sin embargo, esta distinción es fundamental: generar una secuencia larga con coherencia estadística y propiedades biológicas plausibles no equivale a crear un organismo funcional. Los propios autores reconocen que todavía carecemos de una comprensión suficiente de la complejidad codificada por los genomas como para componer de manera inteligente sistemas biológicos completamente nuevos.

Una secuencia puede parecer genómica, contener genes y patrones regulatorios reconocibles y resultar convincente para distintos modelos computacionales sin que, al sintetizarla e introducirla en una célula, produzca necesariamente un sistema viable, estable o predecible.

La célula mínima y una lección de humildad

La biología sintética ya había mostrado esa dificultad mucho antes de los actuales modelos generativos.

En 2016, investigadores del J. Craig Venter Institute construyeron JCVI-syn3.0, una célula bacteriana con un genoma sintético de aproximadamente 531.000 pares de bases y sólo 473 genes. Era una aproximación experimental a una célula mínima capaz de autorreplicarse.

El experimento resulta especialmente interesante por lo que salió mal. Un primer intento de diseñar el genoma mínimo a partir del conocimiento disponible no produjo una célula viable. Fueron necesarios tres ciclos de diseño, síntesis y prueba, apoyados en mejores experimentos de mutagénesis, para identificar genes que parecían prescindibles pero resultaban necesarios para un crecimiento robusto.

El resultado final conservó 473 genes y, de manera reveladora, 149 de ellos todavía no tenían entonces una función biológica conocida. Una década después, nuevas investigaciones continúan intentando determinar la función de parte de esos genes.

La enseñanza es difícil de ignorar. Podemos sintetizar físicamente un genoma, reducirlo a unos pocos cientos de genes y obtener una célula capaz de reproducirse, pero eso no significa que comprendamos completamente cómo todas sus partes producen un sistema vivo funcional. La inteligencia artificial puede acelerar ese proceso de aprendizaje y explorar combinaciones imposibles de evaluar manualmente, pero no elimina la complejidad emergente de la vida.

Entonces, ¿estamos diseñando vida?

La respuesta depende de qué entendamos por diseñar.

Hoy ya podemos generar proteínas funcionales con secuencias muy alejadas de las conocidas, proponer nuevos editores genéticos y producir largas secuencias de ADN con características genómicas plausibles. Pero son capacidades diferentes y no conviene colocarlas en el mismo nivel.

Una proteína sintetizada y validada experimentalmente demuestra una función molecular concreta. Una secuencia genómica generada por un modelo demuestra, en cambio, que el sistema aprendió regularidades del ADN a gran escala. No demuestra que haya creado un organismo.

Si por “diseñar vida” entendemos describir una función y recibir de una inteligencia artificial el genoma de un organismo completamente nuevo, sintetizarlo y obtener de manera predecible una célula viable con el comportamiento solicitado, todavía estamos lejos. Mucho más lejos aún se encuentra la idea de diseñar organismos multicelulares complejos de la misma forma en que hoy generamos una imagen mediante una instrucción de texto.

La diferencia no es sólo cuantitativa. Las propiedades de una célula emergen de redes de regulación, metabolismo, interacciones moleculares, estado epigenético y condiciones ambientales. En organismos multicelulares se agregan desarrollo, diferenciación, arquitectura de tejidos, inmunidad y una enorme cantidad de interacciones dinámicas. La secuencia de ADN es fundamental, pero no constituye por sí sola una descripción completa del sistema.

El laboratorio sigue teniendo la última palabra

Esta limitación explica por qué el futuro más inmediato probablemente no sea una IA que “fabrique vida” de manera autónoma, sino sistemas que cierren progresivamente el ciclo entre diseño computacional y experimentación.

Un modelo puede proponer miles de candidatos; herramientas de predicción pueden descartar muchos de ellos; un laboratorio automatizado sintetiza y prueba una selección; los resultados regresan al sistema y una nueva generación de diseños intenta mejorar lo anterior.

La transformación puede ser enorme aunque cada paso continúe requiriendo validación experimental. La ventaja de la inteligencia artificial no consiste necesariamente en acertar a la primera, sino en reducir un espacio de posibilidades prácticamente inabarcable mediante la exploración convencional.

El laboratorio deja así de ser únicamente el lugar donde se ejecuta una hipótesis concebida previamente por una persona y empieza a formar parte de un circuito iterativo entre algoritmos, robótica y experimentación. Ya vimos los primeros ejemplos de esta convergencia en el descubrimiento de medicamentos mediante inteligencia artificial. En biología generativa, sus consecuencias podrían ser todavía más profundas.

El problema del doble uso

Las mismas características que hacen atractiva a la biología generativa para desarrollar medicamentos, enzimas industriales, materiales o nuevas herramientas diagnósticas plantean inevitablemente un problema de bioseguridad. Una tecnología capaz de generar secuencias novedosas no tiene por qué limitarse a funciones beneficiosas.

Estamos frente a un ejemplo clásico de tecnología de doble uso: una misma capacidad puede tener aplicaciones legítimas y, bajo otras condiciones, usos perjudiciales.

Conviene evitar dos extremos. El primero consiste en asumir que una IA actual puede producir, a partir de una simple instrucción, cualquier organismo peligroso imaginable. La evidencia disponible no justifica esa imagen. Persisten barreras importantes de conocimiento, experimentación, síntesis, ensamblaje y validación.

El segundo extremo sería concluir que el riesgo puede ignorarse hasta que esas capacidades sean completas. Precisamente porque el progreso es gradual, los mecanismos de seguridad probablemente deban evolucionar junto con la capacidad tecnológica y no aparecer únicamente cuando el problema ya esté plenamente desarrollado.

Bioseguridad: cuando reconocer una secuencia deja de ser suficiente

Durante años, una parte importante de la bioseguridad asociada a la síntesis de ADN se apoyó en una idea razonable: comparar los pedidos de secuencias con bases de datos de agentes o toxinas conocidos y revisar aquellas coincidencias que pudieran representar un riesgo.

Ese enfoque continúa siendo útil, pero la biología generativa introduce una dificultad nueva. Dos proteínas pueden conservar funciones relacionadas aun cuando sus secuencias se hayan alejado considerablemente. Un sistema generativo puede, por lo tanto, explorar moléculas que mantengan determinadas propiedades biológicas sin parecerse demasiado a las secuencias que sirvieron como punto de partida.

En 2026, investigadores vinculados al National Institute of Standards and Technology de Estados Unidos plantearon precisamente este problema y propusieron complementar los actuales sistemas basados en similitud con métodos capaces de evaluar también funciones biológicas de preocupación.

Esto modifica la lógica de la seguridad. Ya no siempre bastará con preguntar: “¿esta secuencia se parece a algo peligroso conocido?”. En algunos contextos será necesario intentar responder una pregunta mucho más difícil: “¿qué podría hacer esta secuencia aunque nunca la hayamos visto antes?”.

¿Dónde deberían colocarse los controles?

No existe una única barrera capaz de resolver el problema. Un enfoque razonable probablemente necesite varias capas. Los modelos de mayor capacidad pueden incorporar restricciones y evaluaciones para usos de alto riesgo; los proveedores de síntesis pueden verificar clientes y analizar pedidos; las instituciones científicas pueden reforzar la revisión de investigaciones de doble uso; y los sistemas de cribado deberán evolucionar a medida que mejoren las herramientas capaces de predecir función.

También comienzan a aparecer propuestas más experimentales. El 30 de septiembre de 2026, Nature publicó SynthIDBio, una prueba de concepto para incorporar marcas detectables a proteínas y estructuras generadas por inteligencia artificial preservando su utilidad biológica. Los investigadores validaron experimentalmente proteínas de unión marcadas que mantuvieron afinidades comparables a las versiones no marcadas.

La idea resulta atractiva como herramienta de procedencia: permitiría reconocer que determinada proteína fue generada mediante un sistema concreto. Pero todavía no constituye un mecanismo de bioseguridad desplegado. Los propios investigadores la presentan como una prueba de concepto y reconocen la necesidad de estandarización y coordinación; además, la marca puede ser eliminada mediante determinadas manipulaciones. Debe entenderse, por lo tanto, como una posible capa adicional de trazabilidad y no como una solución independiente.

El desafío será encontrar proporcionalidad. Controles excesivamente amplios podrían dificultar investigación legítima en medicina, agricultura o biotecnología industrial sin impedir necesariamente un uso malicioso. Controles demasiado débiles podrían quedar rápidamente obsoletos frente a modelos capaces de explorar secuencias cada vez más alejadas de las conocidas.

Probablemente la discusión deba centrarse menos en prohibir herramientas genéricas y más en identificar combinaciones concretas de capacidad, acceso, síntesis y función que justifiquen distintos niveles de supervisión.

Una frontera que se mueve muy rápido

La expresión “biología generativa” puede sonar futurista, pero algunas de sus piezas fundamentales ya existen. Diseñamos proteínas de novo, generamos nuevos editores genéticos, producimos secuencias de ADN cada vez más largas y conectamos progresivamente el diseño computacional con la experimentación automatizada.

Ninguno de esos avances equivale todavía a dominar la vida como si fuera un lenguaje de programación perfectamente comprendido.

Tal vez la transformación más importante sea otra. Durante décadas, la biotecnología trabajó principalmente observando, seleccionando o modificando organismos y moléculas que la evolución ya había producido. Los modelos generativos permiten comenzar a explorar un espacio mucho mayor: aquellas secuencias y estructuras que podrían ser biológicamente posibles aunque nunca hayan aparecido en la historia natural.

Eso abre oportunidades extraordinarias. Nuevas proteínas podrían convertirse en medicamentos, sensores, materiales, enzimas industriales o herramientas para estudiar enfermedades. Los modelos genómicos podrían ayudarnos a comprender regiones del ADN cuya función todavía ignoramos. Y la combinación de generación computacional y experimentación automatizada podría reducir enormemente algunos ciclos de prueba y error.

Pero también modifica una pregunta fundamental.

Hasta ahora, gran parte de la biología consistía en intentar comprender qué había construido la evolución. Poco a poco estamos entrando en una etapa en la que también tendremos que decidir qué queremos construir nosotros.

Quizá ese sea el verdadero límite de la biología generativa. No estará determinado únicamente por aquello que una inteligencia artificial sea capaz de diseñar, sino también por aquello que consideremos razonable sintetizar, probar y, eventualmente, liberar al mundo.

Bibliografía

  1. Watson JL, Juergens D, Bennett NR, et al. De novo design of protein structure and function with RFdiffusion. Nature. 2023;620:1089–1100. doi:10.1038/s41586-023-06415-8.
  2. Hayes T, Rao R, Akin H, et al. Simulating 500 million years of evolution with a language model. Science. 2025;387:850–858. doi:10.1126/science.ads0018.
  3. Ruffolo JA, Nayfach S, Gallagher J, et al. Design of highly functional genome editors by modelling CRISPR–Cas sequences. Nature. 2025;645:518–525. doi:10.1038/s41586-025-09298-z.
  4. Brixi G, Durrant MG, Ku J, et al. Genome modelling and design across all domains of life with Evo 2. Nature. 2026;652:1349–1361. doi:10.1038/s41586-026-10176-5.
  5. Koh HY, Zheng Y, Yang M, et al. AI-driven protein design. Nature Reviews Bioengineering. 2025;3:1034–1056. doi:10.1038/s44222-025-00349-8.
  6. Yang W, Wang S, Lee GR, et al. The past, present and future of de novo protein design. Nature. 2026;652:1139–1152. doi:10.1038/s41586-026-10328-7.
  7. Hutchison CA III, Chuang RY, Noskov VN, et al. Design and synthesis of a minimal bacterial genome. Science. 2016;351:aad6253. PMID:27013737.
  8. Able G, Alexanian T, Beal J, et al. Beyond sequence similarity: toward function-based screening of nucleic acid synthesis. Frontiers in Bioengineering and Biotechnology. 2026. doi:10.3389/fbioe.2026.1832724.
  9. Wang M, Zhang Z, Bedi AS, et al. A call for built-in biosecurity safeguards for generative AI tools. Nature Biotechnology. 2025;43:845–847. doi:10.1038/s41587-025-02650-8.
  10. Stutz D, Cowen-Rivers AI, Ortiz-Jimenez G, et al. Function-preserving watermarking of AI-generated proteins. Nature. 2026. doi:10.1038/s41586-026-10965-y.

CRISPR + IA: de comprender el código biológico a poder modificarlo

Ilustración de una proteína CRISPR sobre una doble hélice de ADN, conectada a una red digital con forma de rostro.

Durante décadas, uno de los grandes objetivos de la biología fue aprender a leer el código de la vida. Primero pudimos secuenciar genes y, con el tiempo, comenzamos a comprender mejor cómo esas secuencias producen proteínas, cómo se regula su actividad y de qué manera determinadas variantes pueden contribuir al desarrollo de enfermedades. En los últimos años, sin embargo, estamos entrando en una etapa diferente: además de leer e interpretar ese código, empezamos a disponer de herramientas capaces de modificarlo de manera dirigida.

CRISPR fue uno de los grandes saltos que hicieron posible esa transición. La inteligencia artificial puede convertirse en el siguiente.

La combinación entre ambas tecnologías ya está modificando la investigación en edición genética. Los algoritmos pueden ayudar a elegir dónde intervenir en el ADN, anticipar posibles modificaciones no deseadas, seleccionar mejores ARN guía y analizar las consecuencias funcionales de determinadas variantes. Más recientemente, los modelos generativos comenzaron incluso a diseñar nuevas proteínas de edición genética muy diferentes de las nucleasas naturales conocidas.

Este cambio se conecta con otra transformación que ya analizamos en Doctor Digital: el uso de AlphaFold 3 y modelos generativos para comprender interacciones moleculares y diseñar nuevas moléculas. La biología computacional dejó de utilizarse solamente para analizar datos obtenidos en el laboratorio y empieza también a participar en el diseño de nuevas intervenciones biológicas. Sin embargo, entre predecir una modificación y demostrar que funciona de manera segura existe todavía una enorme distancia. La inteligencia artificial puede reducir el espacio de búsqueda, orientar los experimentos y proponer soluciones novedosas, pero la biología continúa teniendo la última palabra.

Qué es CRISPR y por qué cambió la genética

CRISPR surgió en la naturaleza como parte de sistemas de defensa adaptativa presentes en bacterias y arqueas frente a virus y otros elementos genéticos invasores. Estos microorganismos pueden incorporar pequeños fragmentos del material genético del invasor y utilizarlos posteriormente como una especie de memoria molecular que permite reconocerlo.

El descubrimiento de que determinadas proteínas asociadas a CRISPR podían ser dirigidas mediante ARN hacia secuencias específicas de ADN permitió transformar ese mecanismo natural en una herramienta programable de ingeniería genética. Uno de los trabajos fundamentales fue publicado en Science en 2012 por Martin Jinek, Emmanuelle Charpentier, Jennifer Doudna y colaboradores, quienes demostraron que Cas9 podía ser programada mediante ARN para producir cortes en secuencias específicas de ADN.

El sistema experimental CRISPR-Cas9 utilizado habitualmente puede simplificarse en dos componentes principales: una proteína Cas9, capaz de cortar ADN, y un ARN guía que la dirige hacia una región determinada del genoma.

Cuando la secuencia del ARN guía reconoce suficientemente bien la región elegida, Cas9 puede producir una rotura de doble cadena. La célula intenta reparar posteriormente ese daño mediante sus propios mecanismos. Esa reparación puede aprovecharse para inactivar genes y, cuando se combina con plantillas de reparación u otras estrategias, también para introducir modificaciones dirigidas.

Con el tiempo aparecieron tecnologías considerablemente más sofisticadas. Los editores de bases utilizan componentes derivados de CRISPR combinados con otras enzimas para modificar determinadas bases sin necesidad de producir una rotura completa de las dos cadenas del ADN.

La edición primaria, conocida como prime editing, amplió todavía más las posibilidades. Utiliza una Cas9 modificada, una transcriptasa reversa y un ARN guía especializado denominado pegRNA, capaz de especificar tanto el sitio de edición como la modificación deseada. El trabajo original demostró inserciones, deleciones y los doce tipos posibles de sustitución puntual sin requerir una rotura de doble cadena ni una plantilla de ADN donante separada.

Por eso, describir CRISPR simplemente como unas “tijeras genéticas” comienza a resultar insuficiente. En realidad, se está convirtiendo en una plataforma programable de edición molecular y, cuanto más programable se vuelve una tecnología, mayor es el espacio en el que puede intervenir la inteligencia artificial.

El problema de elegir dónde editar

Saber que un determinado gen está relacionado con una enfermedad no significa que cualquier intervención sobre él vaya a resultar eficaz o segura. El genoma humano contiene aproximadamente 3.000 millones de pares de bases y muchas regiones presentan secuencias parcialmente similares. Un ARN guía diseñado para reconocer un sitio determinado puede, en determinadas condiciones, interactuar también con otras regiones.

Estas modificaciones no deseadas se conocen como efectos fuera del objetivo, o off-target. Algunas pueden carecer de consecuencias importantes, pero otras podrían alterar genes o regiones reguladoras relevantes.

Por eso, uno de los primeros campos en los que comenzaron a utilizarse técnicas de aprendizaje automático fue precisamente el diseño de los ARN guía. Los modelos pueden analizar grandes cantidades de experimentos previos y aprender qué características de una secuencia se asocian con una edición más eficiente. Al mismo tiempo, pueden recorrer el genoma buscando regiones suficientemente parecidas como para representar posibles sitios de unión no deseada.

Actualmente existen numerosos algoritmos destinados a estimar dos propiedades fundamentales: la eficiencia, es decir, la probabilidad de que la edición ocurra en el sitio buscado, y la especificidad, relacionada con la capacidad de evitar modificaciones en otras regiones.

Una revisión publicada en Nature Reviews Genetics, cuyo número impreso corresponde a 2026, describe precisamente el diseño de ARN guía, la predicción de actividad on-target y off-target, la ingeniería de proteínas editoras y el descubrimiento de nuevas enzimas como algunos de los principales campos en los que la inteligencia artificial está empezando a transformar la edición genética.

Esto no significa que una computadora pueda garantizar que una edición será segura. Las predicciones dependen de los datos utilizados para entrenar los modelos, del sistema CRISPR empleado, del tipo celular y del contexto biológico. Su función es más concreta y, al mismo tiempo, enormemente útil: permitir que los experimentos comiencen con candidatos mejor seleccionados.

Comprender qué ocurre cuando cambiamos el ADN

Elegir correctamente dónde editar es sólo una parte del problema. Antes de modificar una secuencia también necesitamos comprender qué consecuencias podría tener ese cambio.

Durante mucho tiempo resultó relativamente más sencillo interpretar algunas variantes que alteraban directamente la estructura de una proteína. Mucho más difícil ha sido comprender las variantes presentes en las regiones no codificantes del ADN, que constituyen la mayor parte del genoma y contienen numerosos elementos responsables de regular cuándo, dónde y con qué intensidad se expresan los genes.

Aquí están apareciendo modelos capaces de aprender relaciones entre secuencia y función. Uno de los ejemplos más importantes es AlphaGenome, desarrollado por Google DeepMind y publicado en Nature en enero de 2026.

AlphaGenome puede analizar regiones de hasta aproximadamente un millón de pares de bases y generar predicciones sobre numerosos procesos regulatorios, entre ellos expresión génica, accesibilidad de la cromatina, modificaciones de histonas, unión de factores de transcripción, procesamiento del ARN y contactos de cromatina. En las evaluaciones publicadas, igualó o superó a los modelos externos comparados en 25 de 26 conjuntos de pruebas destinados a predecir el efecto de variantes.

AlphaGenome no es un sistema CRISPR y no modifica genes. Su relevancia para la edición genética aparece en una etapa anterior: puede ayudar a modelar cómo una determinada variante se relaciona con cambios funcionales en el genoma.

Esta distinción es importante. CRISPR proporciona una herramienta para realizar una modificación, pero decidir cuál modificación tiene sentido requiere comprender mejor el funcionamiento de las secuencias que queremos cambiar. La inteligencia artificial empieza así a conectar dos problemas que tradicionalmente se abordaban de manera separada: interpretar una variante y anticipar las consecuencias de modificarla.

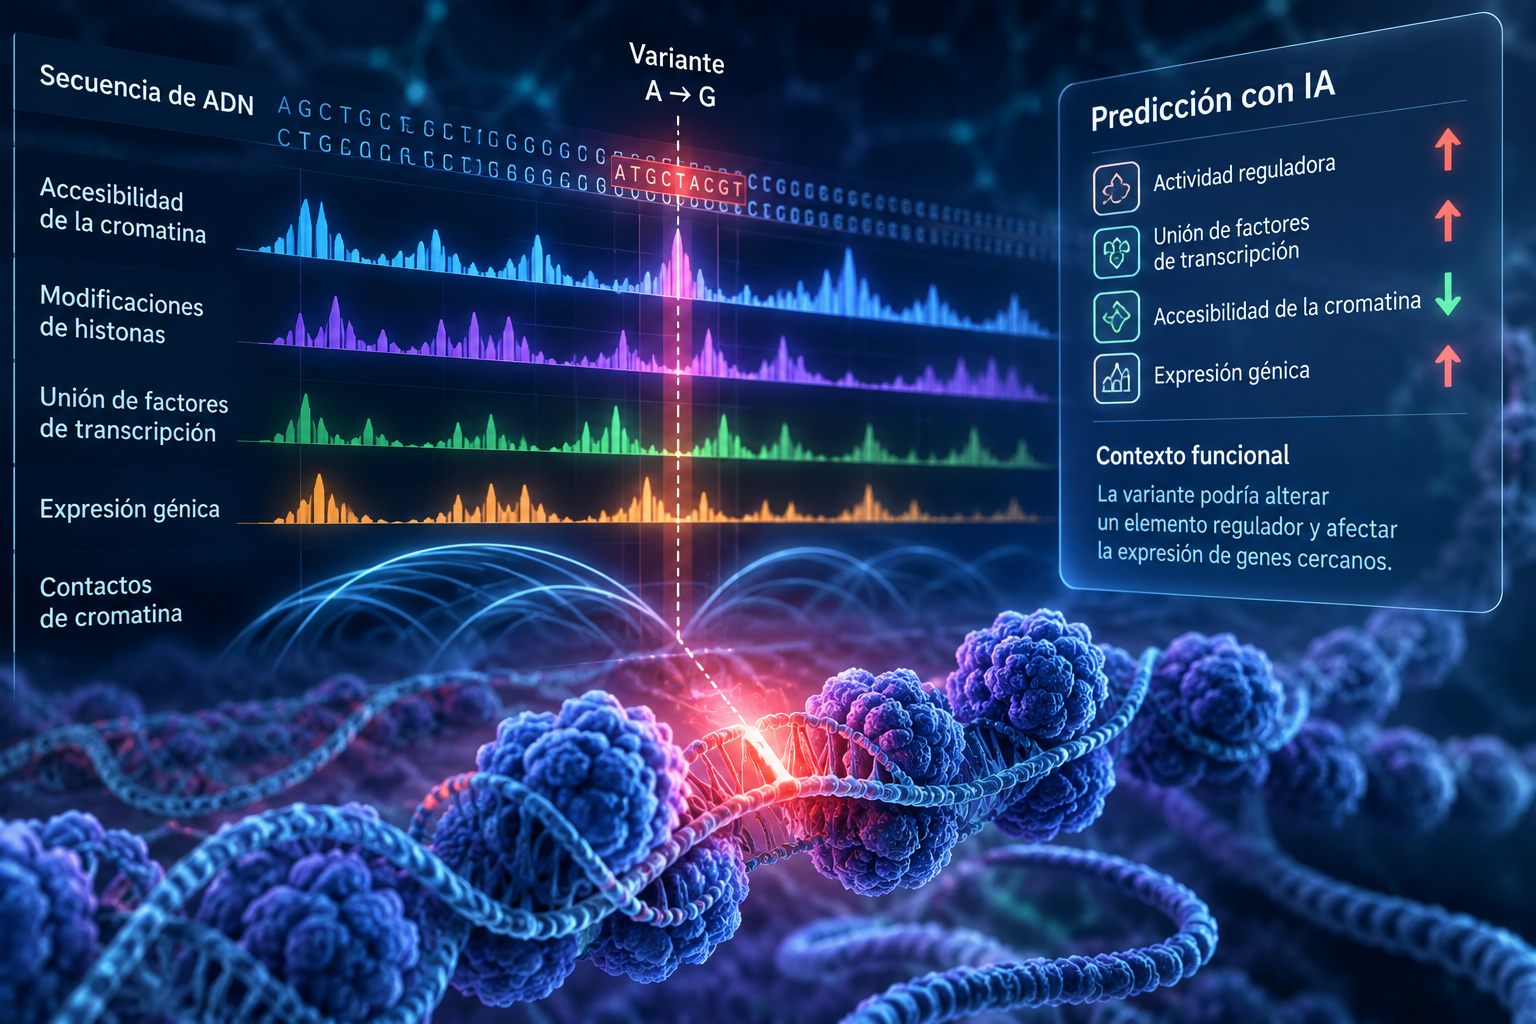
Esquema de una variante de ADN y señales de cromatina, factores de transcripción y expresión génica analizadas mediante IA.
Esquema ilustrativo de predicción de efectos regulatorios de una variante; las señales y flechas no corresponden a resultados experimentales.

La IA puede mejorar las herramientas CRISPR

La inteligencia artificial no sólo puede utilizarse para elegir mejores lugares de edición. También puede aplicarse a las propias proteínas que realizan esas modificaciones.

Las nucleasas Cas utilizadas habitualmente fueron descubiertas inicialmente en microorganismos. Cas9, Cas12 y otras proteínas forman parte de sistemas biológicos que evolucionaron durante millones de años. Una vez identificadas, los investigadores comenzaron a modificarlas mediante ingeniería molecular con distintos objetivos: mejorar su precisión, modificar las secuencias que pueden reconocer, reducir su tamaño o adaptarlas a nuevos sistemas de edición.

Los modelos generativos de proteínas ofrecen una estrategia complementaria. Al analizar enormes cantidades de secuencias, pueden aprender regularidades relacionadas con la estructura y la función de estas moléculas. De una manera conceptualmente similar a cómo un modelo de lenguaje aprende relaciones entre palabras y frases a partir de grandes corpus de texto, un modelo de proteínas puede aprender qué combinaciones de aminoácidos son compatibles con determinadas arquitecturas moleculares.

Una vez entrenado, el sistema puede generar secuencias nuevas, algunas de ellas considerablemente alejadas de las proteínas naturales conocidas. Esto conecta directamente CRISPR con la biología generativa, en la que la computadora deja de limitarse a clasificar o predecir propiedades de moléculas existentes y comienza también a proponer nuevas moléculas candidatas.

OpenCRISPR-1 y los editores diseñados por IA

Uno de los ejemplos más importantes de esta convergencia es OpenCRISPR-1.

El sistema fue presentado inicialmente como preprint en 2024 y posteriormente publicado en Nature el 30 de julio de 2025. En ese trabajo, investigadores de Profluent desarrollaron modelos de lenguaje de proteínas entrenados a partir de un conjunto que incluía más de un millón de operones CRISPR obtenidos mediante el análisis de aproximadamente 26 terabases de genomas y metagenomas.

Los modelos generaron millones de secuencias candidatas pertenecientes a distintas familias CRISPR-Cas. Varios de los editores obtenidos mostraron actividad y especificidad comparables o superiores a SpCas9, a pesar de encontrarse aproximadamente a 400 mutaciones de distancia de esta proteína en términos de secuencia.

Uno de ellos fue denominado OpenCRISPR-1. Los investigadores demostraron que podía editar ADN en células humanas y que también era compatible con sistemas de edición de bases.

El trabajo resulta especialmente relevante porque demuestra que los modelos generativos pueden explorar regiones del espacio de secuencias muy alejadas de las proteínas naturales conocidas y generar moléculas que conservan una función biológica útil. No es necesario afirmar que esas regiones “nunca fueron recorridas por la evolución”, algo que no podemos demostrar; basta con señalar que muchas de las secuencias propuestas son muy diferentes de las proteínas que conocemos actualmente.

El concepto es probablemente más importante que una proteína particular. Durante décadas, gran parte de la biotecnología siguió una estrategia basada en descubrir herramientas interesantes en la naturaleza y modificarlas posteriormente. La biología generativa introduce otra posibilidad: partir de determinadas propiedades deseadas y utilizar modelos computacionales para proponer moléculas candidatas.

Después será necesario sintetizarlas, probarlas y compararlas experimentalmente. La computadora no elimina el laboratorio, pero puede ayudar a decidir qué pequeñas regiones de un espacio molecular gigantesco merece la pena explorar.

Modelos digitales de proteínas convergen en una nucleasa azul y violeta asociada a una cadena de ADN.
Los modelos generativos proponen proteínas editoras que después deben sintetizarse y validarse en el laboratorio.

La validación independiente de OpenCRISPR-1

Una cuestión especialmente importante en ciencia es saber si un resultado puede reproducirse fuera del grupo que desarrolló originalmente la tecnología.

En mayo de 2026, investigadores independientes publicaron en Genome Medicine una evaluación de OpenCRISPR-1 en diferentes sistemas de edición. El trabajo mostró que esta nucleasa podía mantener una actividad on-target comparable con SpCas9 en distintos loci y, al mismo tiempo, presentar una reducción importante de determinadas actividades off-target. Los investigadores también demostraron su utilización en estrategias de prime editing.

Esta validación independiente refuerza la idea de que los editores diseñados mediante modelos generativos no constituyen solamente una demostración computacional. Al menos algunos pueden funcionar como herramientas experimentales reales.

Esto no implica que OpenCRISPR-1 vaya a reemplazar a Cas9 ni que todos los editores generados por inteligencia artificial sean necesariamente mejores. La relevancia del ejemplo radica en demostrar que la generación computacional de nucleasas funcionales es técnicamente posible y puede producir moléculas con propiedades útiles.

De AlphaFold a la edición del genoma

Estas tecnologías suelen presentarse de manera separada, aunque en realidad comienzan a formar parte de un mismo proceso.

Modelos como AlphaFold ayudan a predecir estructuras de proteínas y, con nuevas generaciones de modelos, también determinadas interacciones moleculares. Los modelos genómicos intentan relacionar secuencias de ADN con regulación y función. Los algoritmos especializados en CRISPR pueden seleccionar ARN guía y anticipar posibles sitios fuera del objetivo, mientras que los modelos generativos de proteínas comienzan a diseñar nuevas herramientas moleculares.

CRISPR agrega a todo ese conocimiento una capacidad particularmente poderosa: intervenir físicamente sobre el genoma.

El resultado es una integración progresiva entre comprensión y manipulación. En un futuro, distintos modelos podrían contribuir a identificar una variante potencialmente patogénica, estimar cómo altera la función de un gen, comparar estrategias para corregirla y seleccionar una herramienta de edición adecuada. Otros sistemas podrían analizar posibles efectos no deseados o incluso proponer versiones modificadas de la propia proteína utilizada para realizar la intervención.

Cada etapa seguiría necesitando validación experimental, pero la cantidad de decisiones que pueden ser asistidas computacionalmente aumenta rápidamente. La inteligencia artificial deja así de ser solamente una herramienta para interpretar experimentos y empieza a participar en el proceso de diseño experimental.

¿Puede una IA diseñar una terapia genética?

Algunos de los componentes necesarios para hacerlo ya existen, aunque eso no significa que podamos automatizar el desarrollo completo de una terapia.

Los modelos pueden ayudar a identificar blancos, priorizar ARN guía, estimar riesgo off-target, interpretar variantes y optimizar proteínas. Sin embargo, convertir una estrategia de edición en un tratamiento eficaz exige resolver problemas que van mucho más allá de la secuencia del ADN.

Una modificación que funciona correctamente en una línea celular puede comportarse de manera diferente en otro tejido. También es necesario determinar cómo llevar el editor hasta las células adecuadas, durante cuánto tiempo permanecerá activo, qué proporción de células será modificada y cuál será la respuesta inmunológica del organismo.

Además, la biología no puede reducirse a una colección de secuencias independientes. Genes, proteínas, metabolismo, ambiente celular y señales provenientes de otros tejidos interactúan de manera permanente.

Por este motivo, otra frontera de investigación se orienta hacia los llamados modelos celulares virtuales, que intentan predecir cómo responderá una célula frente a determinadas perturbaciones. Su eventual integración con CRISPR podría mejorar nuestra capacidad para anticipar las consecuencias de una intervención, aunque todavía estamos hablando de un área de investigación emergente y no de una tecnología clínica establecida.

Menos experimentos, pero mejor seleccionados

Uno de los impactos más importantes de la inteligencia artificial sobre la biología probablemente no sea reemplazar los experimentos, sino ayudarnos a elegir cuáles vale la pena realizar.

El número de combinaciones posibles en biología molecular es extraordinariamente grande. Podemos diseñar miles de ARN guía contra un mismo conjunto de genes y millones de variantes diferentes de una proteína. Si además consideramos combinaciones entre mutaciones, contextos celulares y estrategias de administración, el espacio experimental se vuelve prácticamente imposible de recorrer mediante prueba y error.

Los modelos permiten reducir ese universo. A partir de millones de posibilidades pueden seleccionar algunos miles de candidatos y, posteriormente, priorizar un conjunto mucho menor para llevar al laboratorio.

Cuando esos experimentos generan nuevos datos, la información puede incorporarse nuevamente a los modelos y mejorar las predicciones futuras. Se forma así un ciclo en el que simulación y experimentación se retroalimentan continuamente.

Este mecanismo posiblemente sea uno de los cambios más profundos que introduzca la inteligencia artificial en la investigación biomédica. No elimina la experimentación; modifica la manera de decidir qué experimentar. En lugar de recorrer enormes espacios de posibilidades casi a ciegas, los investigadores pueden concentrar recursos sobre regiones previamente priorizadas mediante predicciones computacionales.

El límite sigue siendo la biología real

La velocidad con la que avanzan estos modelos puede producir una impresión engañosa. Generar una secuencia molecular plausible no demuestra que una proteína funcione, del mismo modo que predecir un bajo riesgo de efectos fuera del objetivo no garantiza que una edición vaya a comportarse exactamente como esperamos dentro de un organismo.

Los modelos de inteligencia artificial aprenden a partir de los datos disponibles. Si determinados tejidos, tipos celulares, mecanismos moleculares o poblaciones están insuficientemente representados, sus predicciones también pueden resultar menos fiables en esos contextos.

Además, incluso un modelo muy preciso trabaja necesariamente con una representación incompleta de la realidad. Ninguna simulación actual reproduce todas las interacciones que tienen lugar en una célula y mucho menos en un organismo completo.

La validación experimental continúa siendo, por lo tanto, el árbitro final. Los modelos pueden establecer prioridades, detectar patrones difíciles de reconocer y generar hipótesis novedosas, pero cada nueva herramienta de edición deberá demostrar experimentalmente que funciona y que lo hace con un margen de seguridad aceptable.

La diferencia entre predicción y demostración será cada vez más importante a medida que la inteligencia artificial pueda producir moléculas, estrategias de edición e hipótesis biológicas a una velocidad muy superior a nuestra capacidad para comprobarlas.

Una tecnología que también plantea límites éticos

La combinación entre inteligencia artificial y edición genética amplifica algunas de las preguntas que CRISPR ya había planteado por sí sola.

No es equivalente corregir una mutación en células somáticas de una persona con una enfermedad grave que introducir modificaciones heredables en embriones humanos. Tampoco tienen las mismas implicancias utilizar estas herramientas para tratar una enfermedad que emplearlas con el objetivo de modificar características humanas sin una indicación médica.

A medida que el diseño molecular se vuelva más accesible, será necesario discutir simultáneamente seguridad, regulación, acceso y mecanismos de supervisión. La inteligencia artificial puede disminuir algunas barreras técnicas, pero no resuelve las preguntas sociales y éticas relacionadas con aquello que consideramos aceptable modificar.

También existe un problema de distribución. Las terapias avanzadas pueden ser científicamente extraordinarias y, al mismo tiempo, resultar inaccesibles para gran parte de la población debido a su costo y complejidad. La verdadera dimensión de esta revolución no dependerá solamente de cuántas enfermedades puedan ser abordadas mediante edición genética, sino también de quiénes podrán beneficiarse de ella.

La capacidad técnica para realizar una modificación nunca determina por sí sola que debamos realizarla. Cuanto más poderosas se vuelvan estas herramientas, más importante será conservar esa distinción.

De comprender la vida a poder modificarla

La revolución genómica comenzó permitiéndonos leer el ADN. CRISPR proporcionó después una de las primeras herramientas verdaderamente programables para modificarlo y la inteligencia artificial está empezando a conectar ambas capacidades.

Los nuevos modelos genómicos intentan predecir qué significan determinadas secuencias y anticipar las consecuencias funcionales de ciertas variantes. Los algoritmos especializados en CRISPR ayudan a seleccionar dónde intervenir y a reducir el riesgo de modificaciones no deseadas. Al mismo tiempo, los modelos generativos empiezan a diseñar nuevas proteínas que podrían convertirse en herramientas moleculares de una próxima generación de editores.

Todavía estamos lejos de disponer de un sistema al que podamos describir una enfermedad y que automáticamente produzca una modificación genética segura y eficaz. Sin embargo, varias de las piezas necesarias para construir procesos mucho más asistidos por inteligencia artificial ya empiezan a existir.

Esto marca un cambio conceptual importante. La inteligencia artificial aplicada a la biología está dejando de ser únicamente una tecnología destinada a observar, clasificar y predecir fenómenos biológicos. También empieza a convertirse en una herramienta capaz de participar en el diseño de nuevas moléculas y nuevas intervenciones.

Este proceso forma parte de una transformación más amplia de la medicina y la investigación biomédica, en la que la inteligencia artificial empieza a integrarse en tareas clínicas, científicas y de gestión del conocimiento, aunque siempre con la necesidad de validación y supervisión humana.

Durante muchos años nos preguntamos hasta dónde podría llegar una computadora en su intento de comprender el código de la vida. La aparición de CRISPR, los modelos genómicos y la biología generativa agrega ahora una pregunta mucho más profunda: hasta dónde estaremos dispuestos a utilizar ese conocimiento para reescribirlo.

Fuentes y lecturas recomendadas

  • Thomson T, Li G, Strilchuk A, et al. Harnessing artificial intelligence to advance CRISPR-based genome editing technologies. Nature Reviews Genetics. 2026;27:212–230. DOI: 10.1038/s41576-025-00907-1. Nature Reviews Genetics.
  • Ruffolo JA, Nayfach S, Gallagher J, et al. Design of highly functional genome editors by modelling CRISPR–Cas sequences. Nature. 2025;645:518–525. DOI: 10.1038/s41586-025-09298-z. Nature.
  • Hwang HY, Yi H, Gwon Y, et al. High-fidelity genome and prime editing enabled by the AI-designed OpenCRISPR-1. Genome Medicine. 2026;18:109. DOI: 10.1186/s13073-026-01682-2. Genome Medicine.
  • Avsec Ž, Latysheva N, Cheng J, et al. Advancing regulatory variant effect prediction with AlphaGenome. Nature. 2026;649:1206–1218. DOI: 10.1038/s41586-025-10014-0. Nature.
  • Anzalone AV, Randolph PB, Davis JR, et al. Search-and-replace genome editing without double-strand breaks or donor DNA. Nature. 2019;576:149–157. DOI: 10.1038/s41586-019-1711-4. Nature.
  • Jinek M, Chylinski K, Fonfara I, et al. A programmable dual-RNA-guided DNA endonuclease in adaptive bacterial immunity. Science. 2012;337:816–821. DOI: 10.1126/science.1225829. Science.
  • Rees HA, Liu DR. Base editing: precision chemistry on the genome and transcriptome of living cells. Nature Reviews Genetics. 2018;19:770–788. DOI: 10.1038/s41576-018-0059-1. PubMed.
  • Advancing CRISPR with deep learning: a comprehensive review of models and databases. Molecular Therapy – Nucleic Acids. 2025;36:102691. DOI: 10.1016/j.omtn.2025.102691. ScienceDirect.

AlphaFold 3 y la inteligencia artificial: ¿estamos aprendiendo a diseñar medicamentos?

Modelo tridimensional de una proteína y una molécula candidata a medicamento

Durante buena parte de la historia de la farmacología, descubrir un medicamento ha significado buscar una aguja en un pajar extraordinariamente grande. Los investigadores identifican un mecanismo relacionado con una enfermedad, seleccionan una posible proteína sobre la cual intervenir, prueban miles o millones de compuestos, modifican los candidatos más prometedores y, después de años de experimentación, algunos pocos llegan finalmente a probarse en seres humanos.

La inteligencia artificial está empezando a modificar esa lógica. El cambio no consiste simplemente en analizar más rápido grandes cantidades de información: los nuevos modelos pueden predecir estructuras moleculares, estimar cómo interactúan diferentes moléculas y, cada vez más, proponer estructuras nuevas que podrían presentar determinadas propiedades.

AlphaFold 3 es uno de los ejemplos más importantes de esta transformación, pero para comprender por qué resulta tan relevante conviene recordar de dónde venimos. Durante décadas, conocer la forma de una proteína podía significar años de trabajo, experimentos fallidos y prueba y error. Hoy, una inteligencia artificial puede producir en un tiempo incomparablemente menor una predicción estructural que, aunque no reemplaza al laboratorio, puede cambiar completamente el punto desde el cual comienza una investigación. Y ese podría ser apenas el primer paso.

El problema de conocer la forma de una proteína

Las proteínas realizan buena parte del trabajo dentro de nuestras células. Actúan como enzimas, receptores, señales, transportadores y componentes estructurales. Pero conocer la secuencia de aminoácidos que forma una proteína no significa necesariamente conocer su estructura. Una proteína es una larga cadena de aminoácidos que se pliega sobre sí misma hasta adoptar una compleja forma tridimensional, y esa forma resulta fundamental para determinar cómo funciona, con qué otras moléculas puede interactuar y, en muchos casos, cómo podría ser bloqueada o modificada mediante un medicamento.

Durante décadas, obtener esa estructura fue un formidable problema experimental. Uno de los principales métodos utilizados fue la cristalografía de rayos X. Simplificando mucho el proceso, primero era necesario producir y purificar la proteína y conseguir que formara un cristal suficientemente ordenado, algo que podía convertirse por sí mismo en una tarea difícil y prolongada.

No se trataba simplemente de tomar una fotografía con rayos X. Había que encontrar las condiciones adecuadas para mantener estable la proteína y conseguir su cristalización. Cambiar la temperatura, el pH, las concentraciones o las soluciones utilizadas podía significar comenzar una nueva serie de experimentos. Muchas veces los cristales simplemente no aparecían; otras veces aparecían, pero no tenían la calidad necesaria para obtener una estructura útil.

Conseguir el cristal era solamente una parte del problema. Después debía exponerse a rayos X y analizarse el patrón de difracción producido. A partir de esa información era posible reconstruir la distribución de electrones y finalmente deducir la posición tridimensional de los átomos que componían la proteína. Algunas estructuras importantes requirieron años de trabajo de equipos completos de investigadores, mientras que otras sencillamente permanecieron fuera de nuestro alcance.

Con el tiempo se incorporaron otras herramientas. La resonancia magnética nuclear permitió estudiar determinadas proteínas y sus movimientos en solución, mientras que la criomicroscopía electrónica experimentó un extraordinario desarrollo y permitió determinar grandes estructuras moleculares sin necesidad de cristalizarlas. Todas estas técnicas continúan siendo fundamentales, pero requieren equipamiento especializado, muestras biológicas, experiencia y una considerable cantidad de trabajo experimental.

Mientras tanto, existía una pregunta que intrigaba a los científicos desde hacía décadas: si conocemos la secuencia de aminoácidos de una proteína, ¿podríamos calcular directamente qué forma tridimensional adoptará?

El problema resultó extraordinariamente difícil. Una cadena de aminoácidos puede adoptar un número inmenso de configuraciones posibles y determinar cuál será su estructura estable a partir de la secuencia se convirtió en uno de los grandes desafíos de la biología computacional. Ahí es donde AlphaFold cambió la historia.

En 2020, AlphaFold 2, desarrollado por Google DeepMind, demostró que la inteligencia artificial podía predecir la estructura tridimensional de numerosas proteínas a partir de su secuencia de aminoácidos con una precisión que hasta entonces parecía difícil de alcanzar mediante métodos computacionales. Lo extraordinario no era simplemente obtener una atractiva representación tridimensional en una computadora, sino poder producir en minutos u horas —dependiendo de la complejidad de la proteína y de los recursos computacionales disponibles— una predicción estructural útil para problemas que tradicionalmente podían requerir meses o años de trabajo experimental.

AlphaFold no hizo innecesarias la cristalografía de rayos X, la resonancia magnética nuclear ni la criomicroscopía electrónica. Las estructuras experimentales continúan siendo fundamentales y, de hecho, fueron indispensables para entrenar y validar estos modelos. Lo que cambió radicalmente fue el punto de partida. Ya no siempre teníamos que comenzar completamente a ciegas.

Cristalografía de rayos X y predicción computacional de la estructura de una proteína
De la cristalografía de rayos X a la predicción computacional: la IA ha cambiado el punto de partida del estudio estructural de las proteínas.

Cuatro años después llegó AlphaFold 3, y el problema que intentaba resolver era considerablemente más ambicioso.

AlphaFold 3: ya no se trata solamente de proteínas

AlphaFold 3 amplió el objetivo de sus predecesores. Ya no intenta solamente predecir cómo se pliega una proteína, sino modelar complejos formados por diferentes moléculas biológicas. El sistema puede trabajar con proteínas, ADN, ARN, pequeñas moléculas, iones y determinadas modificaciones químicas e intentar predecir cómo interactúan entre sí.

Para el desarrollo de medicamentos, esa capacidad resulta especialmente interesante. Podemos imaginarlo mediante una analogía sencilla: conocer la estructura de una proteína equivale aproximadamente a conocer la forma de una cerradura, mientras que comprender cómo diferentes moléculas interactúan con ella comienza a mostrarnos qué tipo de llave podría encajar. Pero todavía queda un problema considerablemente más difícil: diseñar esa llave.

De predecir moléculas a diseñarlas

Aquí aparece otra rama de la inteligencia artificial: los modelos generativos. Un sistema generativo no necesita limitarse a analizar moléculas existentes, sino que puede proponer estructuras nuevas intentando satisfacer determinadas condiciones.

En teoría, el proceso puede comenzar con una proteína relacionada con una enfermedad. Los modelos analizan su estructura y sus posibles sitios de unión; otros algoritmos generan moléculas candidatas y estiman propiedades como afinidad, estabilidad o determinadas características farmacológicas, y las alternativas consideradas más prometedoras pasan posteriormente a síntesis y experimentación.

El cambio conceptual es considerable. El descubrimiento tradicional de medicamentos ha dependido en buena medida de explorar enormes bibliotecas de compuestos buscando aquellos que presentan alguna actividad interesante. La inteligencia artificial plantea la posibilidad de recorrer ese gigantesco espacio químico de una manera mucho más dirigida. En lugar de buscar solamente una llave entre millones de llaves existentes, empezamos a preguntarnos si podemos diseñarla.

Esto no significa que el laboratorio vaya a desaparecer. Las moléculas propuestas por una computadora deben ser sintetizadas y posteriormente sometidas a pruebas bioquímicas, celulares, toxicológicas y finalmente clínicas. La diferencia potencial consiste en llegar al laboratorio con candidatos mejor seleccionados: la inteligencia artificial no elimina el experimento, pero puede ayudarnos a decidir qué experimentos merece la pena realizar.

Del algoritmo a la fase III

La pregunta decisiva es si todo esto funciona fuera de una computadora. Uno de los ejemplos más interesantes es rentosertib, anteriormente denominado ISM001-055, una pequeña molécula desarrollada para el tratamiento de la fibrosis pulmonar idiopática.

En este proyecto, plataformas de inteligencia artificial participaron tanto en la identificación de TNIK como posible blanco terapéutico como en el desarrollo posterior de una molécula destinada a inhibirlo. El programa consiguió algo mucho más importante que funcionar en una simulación: llegó a pacientes.

En 2025, Nature Medicine publicó los resultados de un ensayo fase IIa multicéntrico, doble ciego y aleatorizado en 71 pacientes con fibrosis pulmonar idiopática. Los participantes recibieron placebo o diferentes dosis de rentosertib durante 12 semanas. En el grupo tratado con 60 mg diarios se observó un aumento promedio de 98,4 ml en la capacidad vital forzada, frente a una disminución de 20,3 ml en el grupo placebo.

Los resultados fueron interesantes, aunque debían interpretarse con cautela. Se trataba de un estudio pequeño y de corta duración, que no permitía establecer todavía una eficacia clínica definitiva. En julio de 2026, sin embargo, Insilico Medicine anunció el inicio del desarrollo en fase III de rentosertib.

Esto convierte al programa en un caso particularmente relevante: un blanco terapéutico identificado mediante inteligencia artificial y una molécula desarrollada con participación importante de sistemas generativos han conseguido avanzar hasta una etapa clínica a la que habitualmente sólo llega una pequeña fracción de los candidatos iniciales.

Rentosertib todavía no es un medicamento aprobado y será necesario esperar los resultados de los estudios confirmatorios. Tampoco un único caso permite demostrar que la inteligencia artificial pueda producir sistemáticamente medicamentos mejores. Sí demuestra, en cambio, algo que hace pocos años parecía mucho más lejano: una molécula surgida de un proceso fuertemente asistido por inteligencia artificial puede recorrer el camino desde un algoritmo hasta ensayos clínicos avanzados.

La inteligencia artificial tampoco escapa al fracaso

Contar únicamente historias como la anterior resultaría atractivo, pero también engañoso. Algunos candidatos identificados o desarrollados mediante plataformas de inteligencia artificial llegaron a ensayos clínicos sin conseguir demostrar la eficacia esperada. La utilización de algoritmos no elimina uno de los principales obstáculos del desarrollo farmacológico: la extraordinaria complejidad de la biología humana.

Una molécula puede unirse perfectamente a una proteína en una simulación y fracasar como medicamento porque se absorbe mal, se metaboliza demasiado rápido, no alcanza el tejido adecuado, interactúa con otras proteínas, produce toxicidad o simplemente porque el mecanismo biológico que parecía fundamental no era tan importante como suponíamos.

El desarrollo de BEN-2293 por BenevolentAI constituye un ejemplo. La molécula, investigada para dermatitis atópica, llegó a un ensayo fase IIa y mostró un perfil de seguridad aceptable, pero no consiguió demostrar los resultados de eficacia esperados y el programa no continuó avanzando.

La diferencia entre diseñar una molécula interesante y desarrollar un medicamento continúa siendo enorme. Una perspectiva publicada en Nature Reviews Drug Discovery en 2026 señalaba precisamente esta dificultad: pese a la enorme cantidad de algoritmos, publicaciones e inversiones, la evidencia de que la inteligencia artificial ya esté produciendo medicamentos más seguros o eficaces para los pacientes continúa siendo limitada. La mayoría de los programas de compañías dedicadas prioritariamente al descubrimiento mediante IA permanecen en etapas preclínicas o clínicas iniciales.

Por eso sigue abierta una pregunta fundamental: ¿la inteligencia artificial permitirá solamente descubrir medicamentos más rápido o conseguirá también descubrir mejores medicamentos? Todavía no conocemos la respuesta.

AlphaFold 3 tampoco es una bola de cristal molecular

Las representaciones tridimensionales producidas por estos sistemas pueden transmitir una impresión engañosa de certeza. Una estructura molecular bellamente representada en una pantalla continúa siendo una predicción, y los propios desarrolladores de AlphaFold 3 describieron limitaciones relacionadas con determinadas conformaciones, estereoquímica, regiones desordenadas y predicciones incorrectas que pueden parecer estructuralmente plausibles.

Existe además una limitación conceptual importante: los sistemas biológicos son dinámicos. Las proteínas no son esculturas rígidas, sino estructuras que se mueven, cambian de conformación, interactúan con otras moléculas y funcionan dentro de ambientes celulares extremadamente complejos.

Un estudio posterior que comparó predicciones de AlphaFold 3 con estructuras experimentales de receptores acoplados a proteínas G mostró bien este problema. El sistema podía reproducir adecuadamente la arquitectura general de muchos receptores, pero la posición exacta de las pequeñas moléculas podía resultar incorrecta, particularmente en determinados sitios de unión alostéricos. Y unos pocos átomos ubicados en una posición diferente pueden importar enormemente cuando intentamos desarrollar un medicamento.

Por eso las estructuras experimentales y la validación en laboratorio continúan siendo fundamentales. AlphaFold 3 no reemplaza a la biología experimental: la complementa.

De la ciencia abierta al acceso controlado

La evolución de AlphaFold abrió también una discusión que va mucho más allá de la predicción de proteínas: ¿hasta qué punto deberían ser abiertos modelos de inteligencia artificial capaces de intervenir cada vez más profundamente sobre la biología?

AlphaFold 2 adoptó un modelo ampliamente abierto para la investigación. Su código fue publicado y sus parámetros quedaron disponibles para la comunidad científica, contribuyendo a una rápida expansión de su utilización en laboratorios de todo el mundo.

Cuando AlphaFold 3 fue presentado en 2024, Google DeepMind eligió inicialmente una estrategia considerablemente más restrictiva. El artículo científico describía el modelo, pero el código completo y sus parámetros no fueron liberados junto con la publicación. Para muchos investigadores, el acceso práctico se realizaba a través de AlphaFold Server, con determinadas limitaciones. La decisión produjo críticas relacionadas con la reproducibilidad científica y puso en evidencia una tensión que probablemente veremos repetirse durante los próximos años entre ciencia abierta, intereses comerciales y control de tecnologías cada vez más poderosas.

La situación posteriormente cambió. El código de AlphaFold 3 fue publicado y, desde junio de 2026, se distribuye bajo licencia Apache 2.0. Los parámetros entrenados del modelo —los llamados pesos—, sin embargo, permanecen bajo términos de uso separados que restringen su redistribución y determinados usos comerciales.

La distinción entre código y parámetros puede parecer técnica, pero es importante: tener el programa que define cómo funciona un modelo no equivale necesariamente a disponer libremente del modelo entrenado que permite reproducir todas sus capacidades.

Las restricciones tampoco pueden atribuirse exclusivamente a la bioseguridad. Intervienen cuestiones comerciales, propiedad intelectual y control sobre determinados usos, aunque los términos asociados al modelo contemplan también restricciones frente a aplicaciones peligrosas, ilegales o maliciosas.

El debate probablemente se repetirá con modelos futuros. La apertura favorece la reproducibilidad, permite que otros investigadores comprueben resultados y acelera la innovación; pero, a medida que estos sistemas dejan de limitarse a describir la biología y adquieren mayor capacidad para ayudar a diseñarla, aparece una pregunta nueva: ¿deberían todas esas capacidades estar disponibles sin ningún tipo de control?

Más allá de AlphaFold 3

La tecnología tampoco se detuvo en AlphaFold 3. En 2026, Isomorphic Labs —empresa de Alphabet surgida específicamente para aplicar inteligencia artificial al descubrimiento de medicamentos— presentó su Drug Design Engine (IsoDDE), que puede entenderse como una evolución de la línea tecnológica de AlphaFold hacia una plataforma específicamente orientada al diseño de fármacos. No se trata oficialmente de un «AlphaFold 4», sino de un sistema que intenta avanzar desde la predicción de estructuras e interacciones biomoleculares hacia problemas directamente relacionados con el desarrollo de nuevas moléculas.

La plataforma pretende ir más allá de la predicción estructural y abordar problemas directamente relacionados con el diseño farmacológico: predecir interacciones entre proteínas y ligandos, estimar afinidades y detectar posibles sitios de unión que podrían utilizarse para desarrollar nuevas moléculas.

La compañía ha comunicado resultados superiores a AlphaFold 3 en determinados benchmarks de interacción proteína-ligando. Es importante interpretar estas afirmaciones correctamente: se trata de resultados comunicados por la propia empresa y no equivalen todavía a demostrar que la plataforma produzca mejores medicamentos en pacientes. Pero muestran claramente la dirección que está tomando el campo.

AlphaFold ayudó inicialmente a responder cómo es una determinada estructura biológica. La siguiente generación de sistemas pretende abordar una pregunta bastante más ambiciosa: qué molécula deberíamos construir para modificarla.

Cuando la inteligencia artificial entra al laboratorio

Existe un paso adicional que puede resultar todavía más importante. Durante 2026, algunos de los principales desarrolladores de inteligencia artificial comenzaron a mostrar sistemas capaces de participar de una manera mucho más activa en el propio proceso de investigación biológica.

OpenAI, trabajando junto con Ginkgo Bioworks, conectó GPT-5 con un laboratorio automatizado para optimizar la producción de proteínas en sistemas libres de células. El modelo podía proponer condiciones experimentales, recibir los resultados obtenidos en el laboratorio y utilizar esa información para decidir nuevas iteraciones. Según los resultados publicados por los investigadores, el proceso consiguió reducir aproximadamente un 40 % el costo de producción de proteínas.

El dato económico es interesante, pero el concepto probablemente sea mucho más importante. La inteligencia artificial ya no se limita necesariamente a analizar información producida previamente por científicos, sino que puede comenzar a participar en un ciclo en el que formula o desarrolla una hipótesis, propone condiciones experimentales, recibe los resultados obtenidos y utiliza esa nueva información para decidir qué experimentar después.

En abril de 2026, OpenAI presentó además GPT-Rosalind, un modelo especializado en ciencias de la vida y orientado a biología, química, ingeniería de proteínas, genómica, descubrimiento de medicamentos y medicina traslacional. Desde septiembre, su acceso se amplió globalmente a organizaciones elegibles mediante un programa de acceso controlado.

Anthropic está explorando un camino similar. En experimentos publicados durante 2026, Claude coordinó diferentes herramientas computacionales especializadas para diseñar pequeñas proteínas capaces de unirse a blancos determinados. Los diseños fueron posteriormente sintetizados y evaluados experimentalmente por laboratorios externos. Se obtuvieron proteínas capaces de unirse a 14 de los 15 blancos estudiados y, dependiendo de la configuración utilizada, entre aproximadamente el 22 % y el 35 % de los diseños evaluados mostraron actividad de unión.

Son resultados prometedores, aunque deben interpretarse con la misma cautela que aplicamos a otros anuncios de este campo: proceden en buena medida de investigaciones realizadas o financiadas por las propias compañías y requieren validación independiente. Sin embargo, muestran una dirección tecnológica particularmente interesante.

Podríamos estar pasando progresivamente de una inteligencia artificial que responde preguntas científicas a otra capaz de actuar como un agente de investigación, consultando literatura, utilizando herramientas especializadas, generando hipótesis, diseñando moléculas, proponiendo experimentos y analizando sus resultados para decidir los pasos siguientes. Lejos de desaparecer, el laboratorio comienza así a conectarse directamente con la inteligencia artificial, cerrando progresivamente el circuito entre la predicción computacional y la experimentación biológica.

Laboratorio automatizado aplicado al descubrimiento de medicamentos mediante inteligencia artificial
Los primeros agentes científicos comienzan a conectar modelos de IA con laboratorios automatizados, generando y evaluando nuevas iteraciones experimentales.

Ese cambio puede resultar mucho más transformador que disponer simplemente de un chatbot que conoce biología.

¿Medicamentos en meses en lugar de años?

Esta es probablemente una de las promesas más atractivas de la inteligencia artificial aplicada a la industria farmacéutica. El desarrollo tradicional de un medicamento puede prolongarse durante más de una década y consumir enormes recursos, mientras que las compañías dedicadas al descubrimiento mediante IA sostienen que determinadas etapas iniciales podrían comprimirse de años a meses.

Existen ejemplos que parecen respaldar parcialmente esa posibilidad. En el caso de rentosertib, sus desarrolladores informaron que la selección del candidato preclínico requirió aproximadamente 18 meses. Pero estas cifras deben interpretarse cuidadosamente, porque acelerar la identificación de un blanco o la generación de una molécula candidata no significa reducir en la misma proporción todo el desarrollo farmacológico.

Los estudios toxicológicos, las diferentes fases clínicas, la fabricación, el seguimiento de seguridad y la evaluación regulatoria continúan siendo necesarios. La verdadera revolución podría ser menos espectacular que algunos titulares y, al mismo tiempo, mucho más importante: si la inteligencia artificial consigue descartar tempranamente miles de alternativas poco prometedoras, el ahorro acumulado de tiempo, experimentos y recursos podría modificar sustancialmente la productividad de la investigación farmacéutica.

Todavía debemos demostrar que esto ocurra de manera consistente.

De buscar medicamentos a diseñarlos

Durante décadas hemos construido enormes bibliotecas de compuestos para probar cuáles podían tener alguna utilidad. Ahora aparece otra posibilidad: comenzar por preguntarnos qué propiedad necesitamos e intentar que un sistema computacional proponga una molécula capaz de proporcionarla.

Este cambio se extiende incluso más allá de los medicamentos tradicionales. Los sistemas actuales de inteligencia artificial participan también en el diseño de proteínas nuevas, incluyendo secuencias que no existen en la naturaleza. El objetivo puede ser crear enzimas, anticuerpos, proteínas terapéuticas u otras estructuras capaces de realizar funciones previamente especificadas.

Aquí la frontera empieza a desplazarse, porque ya no estamos utilizando exclusivamente una computadora para comprender la biología existente. Estamos empezando a utilizarla para proponer biología nueva.

La otra cara de la revolución

Esa capacidad introduce inevitablemente una pregunta incómoda. Si podemos utilizar inteligencia artificial para diseñar una proteína beneficiosa, ¿podrían utilizarse los mismos principios para diseñar una perjudicial?

La respuesta responsable no consiste en afirmar que una inteligencia artificial pueda actualmente crear por sí sola un agente biológico capaz de desencadenar una pandemia o destruir a la humanidad, pero tampoco sería responsable ignorar el problema. Los modelos generativos aplicados a biología presentan lo que se conoce como riesgo de doble uso: herramientas desarrolladas para investigación científica o aplicaciones terapéuticas pueden potencialmente utilizarse con otros objetivos.

Durante 2025 y 2026 esta cuestión comenzó a estudiarse de una manera mucho más concreta. Investigaciones del National Institute of Standards and Technology de Estados Unidos han señalado que los futuros sistemas de diseño biológico podrían generar secuencias suficientemente diferentes de las conocidas como para reducir la eficacia de mecanismos de detección basados exclusivamente en similitud de secuencia. Esto ha llevado a proponer una evolución hacia sistemas capaces de evaluar también la posible función biológica de una secuencia antes de permitir su síntesis.

Pero la misma investigación ofrece un contrapeso importante frente a interpretaciones apocalípticas. En experimentos realizados utilizando sustitutos biológicos seguros, los modelos actuales consiguieron generar proteínas estructuralmente similares a determinadas proteínas originales, pero conservar simultáneamente su función resultó considerablemente más difícil.

Diseñar una estructura plausible no equivale a diseñar un sistema biológico funcional. Pasar de una secuencia producida por una computadora a un agente biológico capaz de comportarse de una manera determinada continúa requiriendo conocimiento especializado, infraestructura experimental, recursos y numerosas etapas de validación.

El riesgo existe y merece anticipación, pero existe una enorme distancia entre reconocer ese riesgo y afirmar que actualmente una inteligencia artificial pueda crear a voluntad cualquier virus o toxina imaginable.

Las propias compañías empiezan a poner límites

Resulta significativo que las empresas que están desarrollando algunos de los modelos más avanzados también hayan comenzado a restringir determinadas capacidades biológicas.

OpenAI considera que sus modelos GPT-5.6 alcanzan el nivel de capacidad “High” en el dominio biológico y químico dentro de su Preparedness Framework, una clasificación que activa salvaguardas adicionales. Para herramientas especializadas en ciencias de la vida ha adoptado además mecanismos de acceso controlado para determinadas organizaciones y usos. Anthropic sigue una estrategia semejante con algunas de sus capacidades biológicas más avanzadas, limitando el acceso a organizaciones verificadas.

Estas decisiones no demuestran por sí mismas que los modelos actuales puedan producir agentes biológicos peligrosos. Sí muestran que sus propios desarrolladores consideran suficientemente plausible el riesgo de doble uso como para incorporar controles antes de que esas capacidades sean todavía mayores.

Aquí aparece una paradoja difícil de evitar: cuanto mejores sean estos sistemas para ayudar a diseñar una proteína terapéutica, encontrar un nuevo antibiótico o responder rápidamente frente a una futura pandemia, mayor podría ser también su capacidad para facilitar investigaciones biológicas potencialmente peligrosas. La misma tecnología puede fortalecer simultáneamente nuestra capacidad de crear y nuestra necesidad de controlar.

Los reguladores también han comenzado a prepararse

La inteligencia artificial aplicada al desarrollo farmacológico ya no es solamente una discusión académica. En enero de 2026, la Food and Drug Administration de Estados Unidos y la Agencia Europea de Medicamentos establecieron conjuntamente diez principios de buenas prácticas para la utilización de inteligencia artificial durante el desarrollo de medicamentos.

Entre ellos aparecen conceptos como diseño centrado en las personas, evaluación proporcional al riesgo, definición clara del contexto en el que se utilizará cada modelo, gobernanza de los datos, documentación, evaluación del rendimiento y supervisión durante todo el ciclo de vida.

Es una señal significativa de que la inteligencia artificial comienza a abandonar el terreno exclusivamente experimental para incorporarse progresivamente a procesos reales de investigación y desarrollo farmacológico. Los reguladores ya no están discutiendo solamente qué podría ocurrir en el futuro, sino cómo evaluar sistemas que empiezan a formar parte del presente.

¿Estamos ante una nueva revolución farmacológica?

Probablemente todavía sea demasiado temprano para afirmarlo. La inteligencia artificial ya transformó la predicción estructural de proteínas y está modificando diferentes etapas del descubrimiento farmacológico. Existen moléculas desarrolladas con una participación importante de IA que llegaron a ensayos clínicos y algunos programas han alcanzado fases avanzadas de desarrollo.

Al mismo tiempo, comenzamos a observar algo nuevo: sistemas de inteligencia artificial que no sólo predicen estructuras o proponen moléculas, sino que pueden utilizar herramientas científicas, diseñar experimentos y aprender de los resultados obtenidos en laboratorios automatizados. Sin embargo, todavía no existe evidencia suficiente para afirmar que estas plataformas produzcan sistemáticamente medicamentos más eficaces, más seguros o con una mayor probabilidad de aprobación. Esa demostración requerirá años.

Y quizá esa sea precisamente la etapa más interesante en la que nos encontramos. Durante décadas utilizamos computadoras fundamentalmente para almacenar, analizar y simular información biológica. Ahora empezamos a utilizarlas para generar hipótesis moleculares, proponer estructuras que antes no existían y participar en el propio ciclo experimental.

Quizás la verdadera revolución no consista en que una inteligencia artificial reemplace al químico, al biólogo o al médico, sino en algo menos espectacular y mucho más profundo: reducir progresivamente el enorme espacio de posibilidades que debemos explorar antes de encontrar una molécula que merezca ser probada en un ser humano y acelerar el ciclo mediante el cual una hipótesis científica se convierte en un experimento y ese experimento genera nuevo conocimiento.

AlphaFold 3 nos permite observar una parte de la biología con una precisión que hace pocos años parecía imposible. Los modelos generativos comienzan a utilizar ese conocimiento para proponer moléculas nuevas, mientras que los primeros agentes científicos empiezan a cerrar el círculo conectando esas predicciones con el laboratorio. Pero entre diseñar una estructura prometedora y disponer de un medicamento seguro y eficaz continúa existiendo un obstáculo formidable: la propia complejidad de la biología humana.

Mientras aprendemos a superar ese obstáculo aparece una segunda pregunta, quizá todavía más difícil: ¿qué límites deberemos establecer cuando las mismas herramientas que nos permiten comprender la biología comiencen también a permitirnos diseñarla?

Bibliografía y fuentes

  1. Abramson J, Adler J, Dunger J, et al. Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature. 2024;630:493–500.
  2. Artificial intelligence in drug discovery: perspectiva sobre el estado del campo. Nature Reviews Drug Discovery. 2026.
  3. Ensayo fase IIa de rentosertib (ISM001-055) en fibrosis pulmonar idiopática. Nature Medicine. 2025.
  4. Insilico Medicine. Insilico initiates Phase III clinical trial of rentosertib. 7 de julio de 2026. Fuente corporativa utilizada para documentar el anuncio del inicio de fase III.
  5. Isomorphic Labs. The Isomorphic Labs Drug Design Engine unlocks a new frontier. 2026. Fuente corporativa.
  6. OpenAI y Ginkgo Bioworks. GPT-5 lowers the cost of cell-free protein synthesis. 2026.
  7. OpenAI. Introducing GPT-Rosalind for life sciences research. 2026.
  8. Anthropic. Claude accelerates protein design. 2026.
  9. NIST. Beyond Sequence Similarity: The Case for Function-Based Screening of Nucleic Acid Synthesis. 2026.
  10. NIST. Experimental Evaluation of AI-Driven Protein Design Risks Using Safe Biological Proxies. 2026.
  11. FDA. Guiding Principles of Good AI Practice in Drug Development. 2026.
  12. Google DeepMind. AlphaFold 3 release history. La versión 3.0.3, publicada en junio de 2026, adoptó Apache 2.0 para el código.